Par O. Bailleux, Maître de conférences HDR à l'université de Bourgogne.
Structures
Les activités #.dec (dec pour Découverte) consistent à étudier des présentations explicatives et à traiter tous les exercices de découverte proposés. Si vous ne répondez pas correctement à un exercice de découverte, revenez en arrière pour relire les explications et identifier la cause de votre erreur.
Les activités #.ent (ent pour Entrainement) consistent à traiter des exercices d’entraînement. Vous devez d’abord tenter de traiter ces exercices sans dévoiler d’indice ni regarder la solution. Vous pouvez remonter dans le document pour relire certaines explications ou consulter les solutions des exercices de découverte ou d’entraînement précédemment traités.
Activité de découverte F.dec
F.dec1 : Notion de structure
Prérequis
| Partie A |
|---|
Objectif
| Regrouper plusieurs données, possiblement de type différents, dans une même capsule |
|---|
Dans les parties précédentes le seul moyen de rassembler plusieurs valeurs était de les placer dans un tableau. Mais cette solution n’est applicable que si les données à agréger sont de même type. Quand nous voulions représenter une donnée complexe regroupant des informations de types différents, nous étions contraint de placer ces informations dans plusieurs variables, et quand on devait les transmettre à des fonction nous utilisions plusieurs paramètres.
Pour simplifier les programmes, il est pratique de pouvoir regrouper plusieurs informations dans une même « capsule ». La notion de structure répond à ce besoin.
Moyen
| Les structures |
|---|
Une structure est un type de donnée permettant de décrire des instances de structures. Une instance de structure regroupe une ou plusieurs informations identifiées par des noms appelé champs.
Voici un premier exemple d’une structure permettant de représenter des points dans un espace à deux dimensions.
typedef struct
{
    double x;
    double y;
}point;
Cette déclaration crée le un type nommé point. Les données de ce type sont constituées de deux champs nommés x et y qui contiennent des valeurs de type double. Les champs d’une structure peuvent avoir n’importe quel type, y compris un type structure ou tableau, et ne sont pas tous nécessairement tous du même type.
Exercice de découverte F.dec.x1
Définissez une structure date permettant de représenter une date constituée d’un jour de la semaine représenté par un entier de type char, un numéro de mois représenté de la même manière, et une année, représentée par une valeur de type int.
typedef struct
{
    char jour;
    char mois;
    int annee;
}date;
On peut déclarer des variables de type structure, les initialiser avec une syntaxe similaire à celle permettant d’initialiser des tableaux, et on peut accéder au valeurs des champs d’une instance de structure en utilisant la syntaxe présentée dans cet exemple.
void test(void)
{
    point p1 = {1.0, 2.0};                 // Ligne A
    printf("(%.02f,%.02f)\n", p1.x, p1.y); // Ligne B
}
En ligne A une variable de type point est déclarée et initialisée. Ce type d’initialisation n’est possible que lors de la déclaration d’une variable de type structure. Par la suite, on ne peut pas utiliser cette syntaxe pour modifier le contenu d’une variable de type structure. La variable point est implantée en mémoire dans la pile.
En ligne B, Les valeurs des deux champs de l’instance de structure située dans la variable p1 sont affichées. La notation p1.x désigne le champs x de l’instance de structure contenue dans la variable p1. Cette syntaxe se généralise à n’importe quel champ d’une structure.
Exercice de découverte F.dec.x2
Donnez les lignes de code permettant de déclarer une variable de type date non initialisée, puis d’assigner la valeur 1 au champ jour, la valeur 3 au champ mois et la valeur 1905 au champ annee de l’instance de structure située dans cette variable.
    date d;
    d.jour = 1;
    d.mois = 3;
    d.annee = 1905;
Bonus
| Copier une instance de structure |
|---|
Vous vous rappelez qu’on ne peut pas copier le contenu d’un tableau dans un autre avec l’opérateur = ? Il faut procéder case par case. Cette limitation est d’ailleurs valable pour les chaînes, puisqu’elles sont représentées par des tableaux.
Il est par contre parfaitement possible de copier le contenu d’une variable de type structure dans une autre en utilisant l’opérateur d’assignation =, comme illustré dans l’exemple suivant…
    point p1 = {1.0, 2.0};
    point p2 = {0.0, 0.0};
    p2 = p1;
    printf("(%.02f,%.02f)\n", p2.x, p2.y);
…qui produit l’affichage :
(1.00,2.00)
Exercice de découverte F.dec.x3
Soient les déclarations suivantes :
    point p1 = {1.0, 2.0};
    point p2 = {0.0, 0.0};
Donnez les lignes de code permettant d’échanger les contenus des variables p1 et p2.
    point tmp = p1;
    p1 = p2;
    p2 = tmp;
Remarque : Il est aussi possible d’échanger les valeurs des champs x et y de chaque variable, mais cela double inutilement la taille du code nécessaire.
F.dec2 : Tableaux de structures
Prérequis
| Partie A, C et D |
|---|
Objectif
| Représenter des données complexes en utilisant des tableaux et des structures |
|---|
Les structures et les tableaux permettent de représenter des collections de données de deux manières différentes. Il peut être utile de combiner les deux, soit en créant des tableaux d’instances de structures, soit en intégrant des tableaux dans des structures, soit les deux. Dans cette section, nous abordons la création de tableaux de structures.
Moyen
| Déclarer des tableaux de structures |
|---|
Un tableau local ou global de structures se déclare de la même manière qu’un tableau local ou global de types scalaires tels que int ou double, par exemple. La ligne suivante déclare un tableaux contenant trois instances de la structure point et initialise ce tableau.
point tab[3] = {{0.0,1.0}, {1.0, 0.0}, {1.0, 1.0}};
Un tableau dynamique de structures se crée d’une manière similaire à celle utilisée pour la création d’un tableau de types scalaires ou pointeurs. Voici un exemple de création d’un tableau de 3 instances de structures de type point dans le tas.
point* t = (point*)calloc(3, sizeof(point));
Les tableaux désignés par tab et par t s’utilisent de la même manière, mais en créant le tableau désigné par t, nous avons contracté une dette mémoire qu’il faudra rembourser avant la fin de l’exécution du programme par l’appel free(t).
Exercice de découverte F.dec.x4
Donnez les lignes de codes permettant de créer dans le tas un tableau non initialisé contenant deux instances de la structure date, puis de placer la date représentant le 7 février 2022 dans les deux cellules de ce tableau.
    date* td = (date*)malloc(2*sizeof(date));
    td[0].annee = 2022;
    td[0].mois = 2;
    td[0].jour = 7;
    td[1] = td[0];
On ne peut pas assigner en une seule fois les valeurs 2022, 2 et 7 aux champs de l’instance de date située dans une variable ou dans une cellule d’un tableau. La syntaxe = {7, 2, 2022} n’est utilisable que lors de la déclaration d’une variable de type date ou d’un tableau global ou automatique d’instances de date. Ici, la solution utilisée consiste à assigner un par un les champs de l’instance de date située dans la première cellule du tableau. Mais une fois cette première cellule assignée, on peut utiliser = pour en recopier le contenu dans le deuxième cellule du tableau.
On aurait aussi pu procéder de la manière suivante :
    date* td = (date*)malloc(2*sizeof(date));
    date tmp = {7, 2, 2022};
    td[0] = tmp;
    td[1] = tmp;
F.dec3 : Structures contenant des tableaux
Prérequis
| Partie A, C et D |
|---|
Objectif
| Représenter des données complexes en utilisant des tableaux et des structures |
|---|
Dans la section précédente, nous avons vu comment créer des tableaux de structures. Nous abordons maintenant les différentes manières de mettre des tableaux dans des structures.
Moyen
| Déclarer des structures ayant un ou plusieurs champs de type tableau ou de type pointeur donnant accès à des tableaux dynamiques. |
|---|
Un champ de structure peut être un tableau de taille fixe dont le contenu est inclus dans l’espace mémoire occupé par une instance de cette structure. Voici un exemple de structure ayant un champ de type tableau de points de taille fixe définie par une constante.
#define NMAX 10

typedef struct
{
    int nSommets;
    point tab[NMAX];
}polygone;
Une instance de cette structure représente un polygone constitué d’un nombre de sommets égal à la valeur du champ nSommets.
Le champ tab représente un tableau de taille fixe dont chaque cellule contient une instance de point. Seule les nSommets premières cellules du tableau tab sont utilisées.
Par exemple, la déclaration suivante crée une instance de polygone représentant un triangle.
polygone t = {3, {{0.0,0.0}, {0.0,1.0}, {1.0,0.0}}};
Seules les trois premières cellules du tableau t.tab sont utilisées. Les 7 autres représentent un espace de stockage perdu.
Exercice de découverte F.dec.x5
Donnez la ligne de code permettant de modifier la coordonnée x du premier point du triangle représenté par l’instance de polygone contenue dans la variable t. La nouvelle valeur doit être 2.0.
t.tab[0].x = 2.0;
L’inconvénient des tableaux de tailles fixes est qu’ils ne permettent pas d’optimiser l’utilisation de la mémoire. À cet égard, il est souvent plus pertinent d’utiliser des tableaux dynamiques.
Voici une nouvelle déclaration de structure ayant le même rôle que la structure polygone mais permettant le stockage des points des polygones représentés dans un tableau dynamique.
typedef struct
{
    int nSommets;
    point* tab;
}poly;
Il est essentiel de comprendre qu’une instance de poly ne contient pas le tableau de stockage des sommets, mais seulement un pointeur sur ce tableau. Il faut donc prévoir une fonction permettant d’initialiser une instance de poly en créant le tableau dynamique de stockage des sommets. Cette initialisation engendrera une « dette mémoire » qui devra être remboursée ultérieurement en libérant la mémoire occupée par le tableau. Cette tache peut être réalisée par une fonction dédiée.
A ce stade, nous devons faire un choix de conception. Pour comprendre le dilemme qui se profile, il faut faire la différence entre une structure monolithique, telle que polygone, et une structure ramifiée, telle que poly.
Voici la représentation en mémoire d’une instance de la structure monolithique polygone.
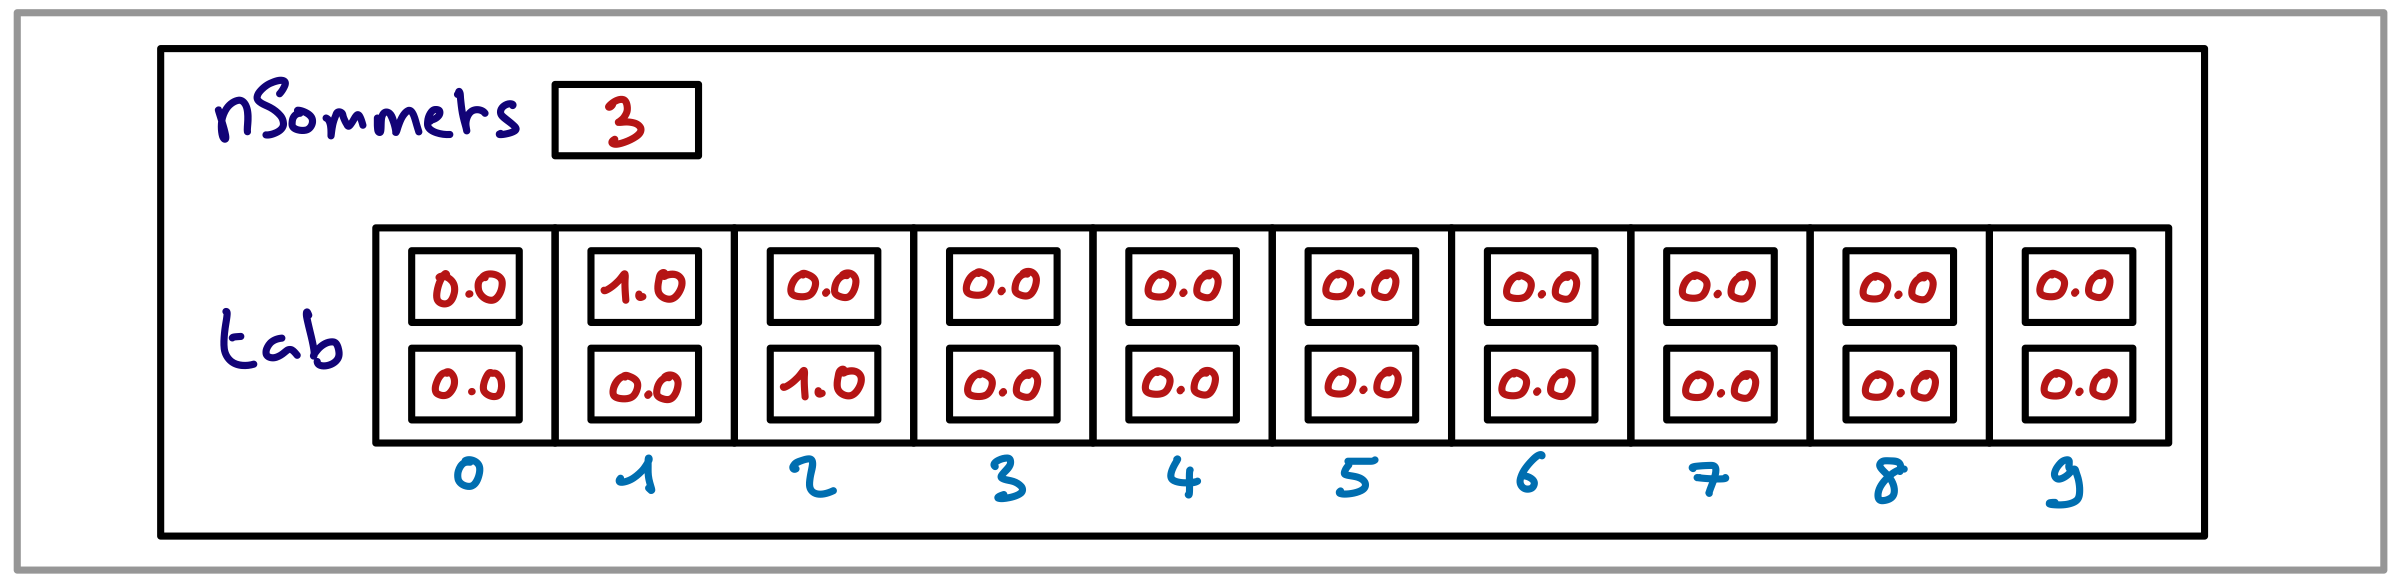
On voit que toutes les données sont regroupées dans une seul bloc mémoire.
Voici maintenant la représentation en mémoire d’une instance de la structure ramifiée poly.
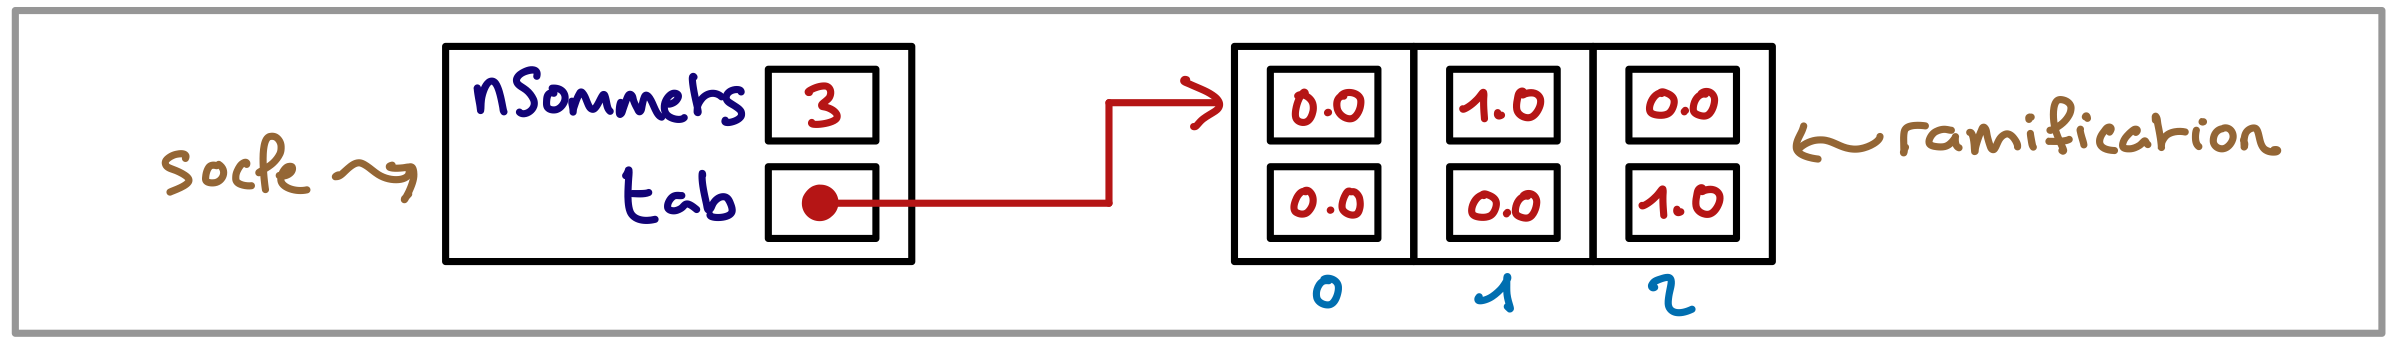
Le socle est une instance de poly qui peut être située dans la pile ou dans le tas. La ramification est un tableau dynamique qui est nécessairement situé dans le tas, car sa taille peut varier selon le nombre de sommets du polygone représenté.
Le dilemme évoqué plus haut est le suivant : doit on placer le socle dans la pile ou dans le tas ? Les deux configurations sont possibles et sont illustrées ci dessous.
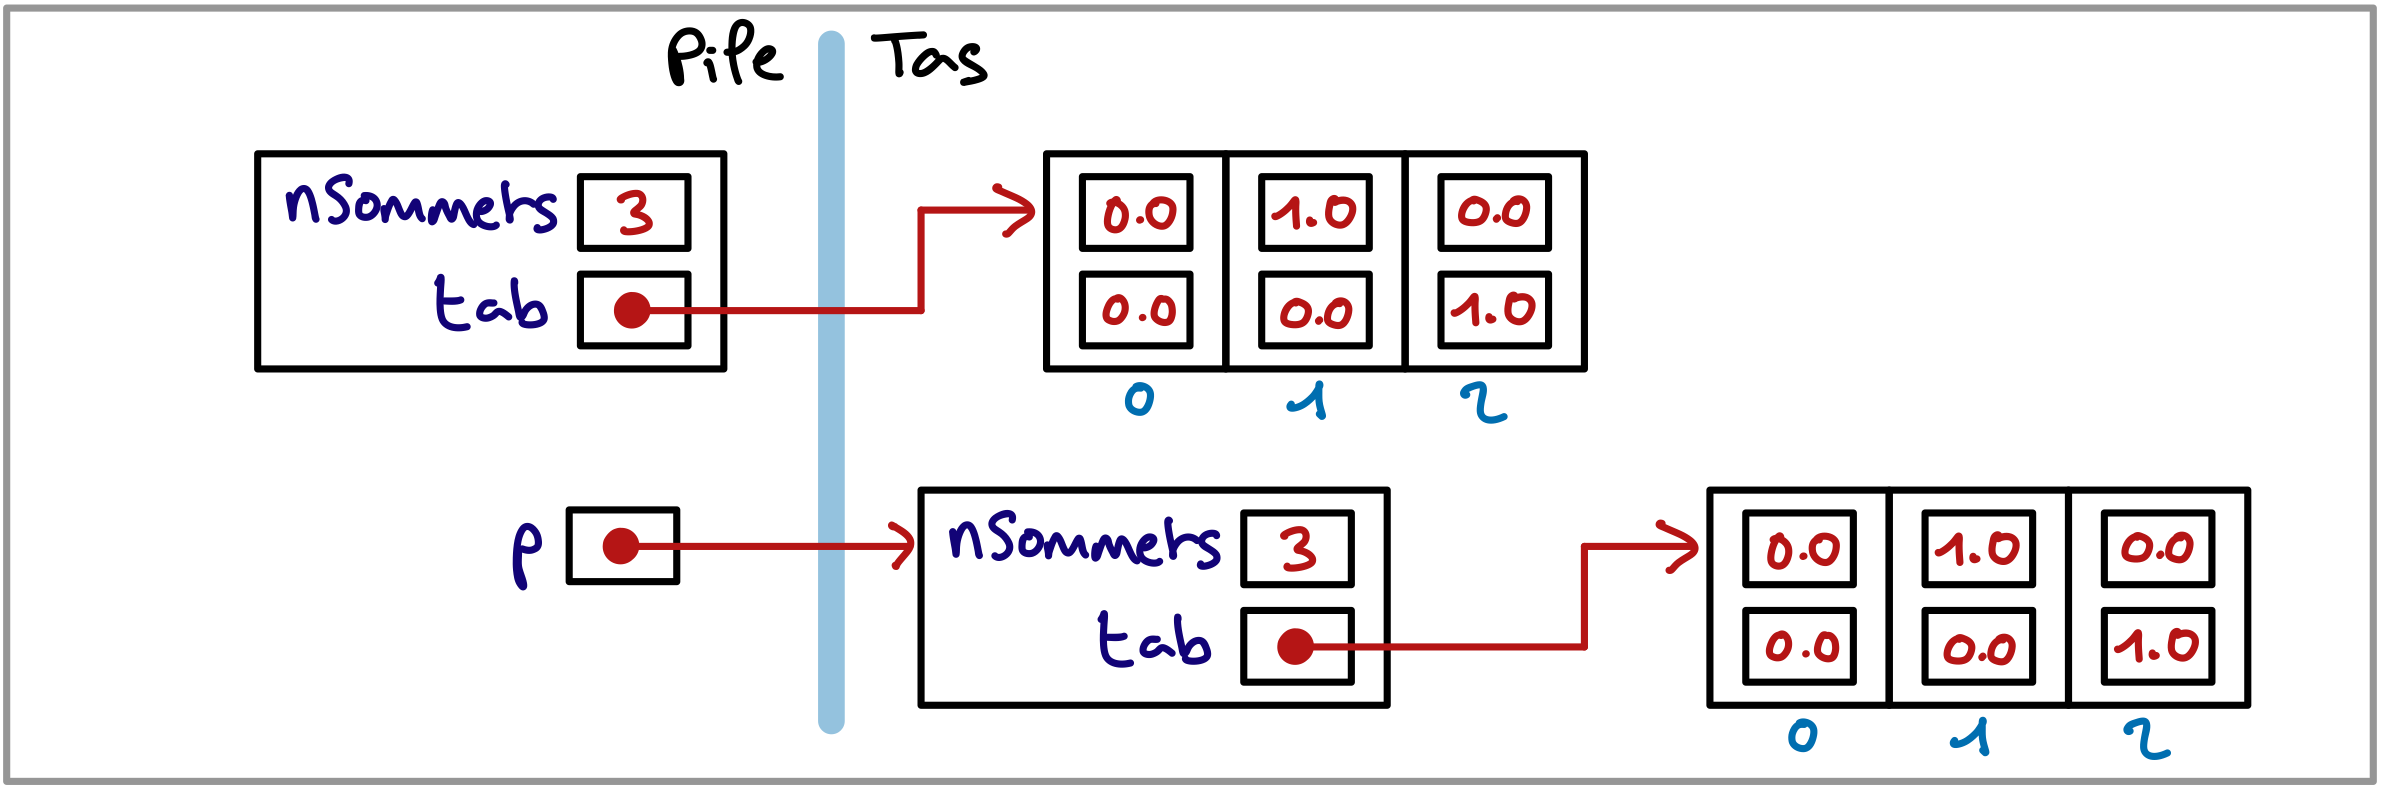
Selon l’option adoptée, les fonctions d’initialisation et de destruction seront différentes et leur utilisation seront différentes. Le parti pris de l’auteur de cet enseignement est de placer les instances de structures ramifiées entièrement dans le tas. Ce choix étant fait, voici la fonction permettant de créer une instance de poly avec sa ramification.
poly* creePoly(int n)
{
    poly* out = (poly*)malloc(sizeof(poly)); // Ligne A
    out->nSommets = n;                       // Ligne B
    out->tab = calloc(n,sizeof(point));      // Ligne C
    return out;                              // Ligne D
}
Le paramètre n de la fonction représente le nombre de sommets du polygone à créer.
La ligne A, réserve dans le tas un bloc mémoire destiné à contenir le socle de l’instance en cours de construction. L’adresse du bloc est placée dans la variable out. La taille du bloc à créer est fournie par sizeof(poly).
En ligne B, une nouvelle notation -> apparait. Elle permet d’accéder à un champ d’une instance de structure à partir de l’adresse mémoire de cette instance. En fait, out->n est un raccourci pour (*out).n, qui désigne le champ n de l’instance de structure poly pointée par out. Ce champ reçoit le nombre de sommets du polygone à créer.
La ligne C réserve le tableau dynamique destiné au stockage des instances de point représentant les points du polygone. Comme la réservation est réalisée par la fonction calloc, les coordonnées de ces points sont initialisées à 0.0. L’adresse du tableau dynamique est placée dans le champ tab du socle.
La ligne D retourne l’adresse de l’instance de poly qui vient d’être créée. Cette instance et sa ramification est constituées de deux bloc mémoire situé dans le tas. Sa création engendre donc une double dette mémoire.
Exercice de découverte F.dec.x6
Donnez les lignes de code permettant de créer une instance de poly représentant un polygone ayant trois sommets et d’assigner les coordonnées (2.0,3.0) au premier sommet. Ceci nécessite d’appeler la fonction creePoly, puis d’accéder aux deux champs x et y de l’instance de point située dans la cellule d’indice 0 du tableau désigné par le champ tab de l’instance de poly dont l’adresse a été retournée par l’appel de la fonction creePoly. N’hésitez pas à relire la phrase précédente, car elle indique que vous devrez utiliser des flèches ->, des points . et des crochets [ ] !
    poly* p = creePoly(3);  // Ligne A
    p->tab[0].x = 2.0;      // Ligne B
    p->tab[0].y = 3.0;      // Ligne C
La ligne A crée une instance de poly et sa ramification et place l’adresse de cette instance dans la variable p.
La ligne B accède au champ tab de l’instance de poly pointée par p. Il faut utiliser la notation p->tab car la variable p contient l’adresse de l’instance de poly dont on veut atteindre le champ tab. Comme p->tab désigne un tableau, il faut utiliser la notation crochet pour accéder à la première cellule de ce tableau qui est p->tab[0]. Cette cellule contient une instance de point, et pas une adresse d’instance de point, c’est donc avec la notation . et non la notation -> qu’on accède au champ x de cette instance, d’où l’expression p->tab[0].x.
La ligne C est évidente quand on a compris la ligne B.
Exercice de découverte F.dec.x7
Définissez la fonction…
void setSommet(poly* p, int i, double x, double y);
…qui assigne les coordonnées (x,y) au sommet i du polygone représenté par l’instance de poly désignée par p. On suppose que cette instance de poly a été préalablement créée par un appel à la fonction creePoly.
void setSommet(poly* p, int i, double x, double y)
{
    p->tab[i].x = x;
    p->tab[i].y = y;
}
Revenons sur la dette mémoire contractée lors de la création par la fonction creePoly d’une instance de poly et de sa ramification. Une telle instance est constituée de deux blocs mémoire, donc sa destruction nécessite deux appels à la fonction free. Voici une fonction réalisant ces opérations.
void deletePoly(poly* p)
{
    free(p->tab);
    free(p);
}
L’ordre des lignes est important. Il faut d’abord libérer le bloc occupé part le tableau, puis le bloc occupé par le socle. Seul les blocs mémoire réservés par malloc ou calloc doivent être libérés (donc pas le champ nSommet).
Exercice de découverte F.dec.x8
Définissez une fonction…
void printPoint(point* p);
…qui affiche les coordonnées d’un point représenté par une instance de la structure point définie plus haut. L’affichage doit être de la forme (1.0,2.0).
void printPoint(point* p)
{
    printf("(%.02f,%.02f)", p->x, p->y);
}
Exercice de découverte F.dec.x9
Définissez une fonction…
void printPoly(poly* p);
…qui affiche la liste des sommets du polygone représenté par l’instance de poly désignée par p. Cette fonction doit appeler la fonction printPoint.
void printPoly(poly* p)
{
    for(int i = 0; i<p->nSommets; i++)
    {
        printPoint(&(p->tab[i]));
    }
    printf("\n");
}
Notez l’utilisation de & pour récupérer l’adresse de l’instance de point représentant chacun des points à afficher. En effet, printPoint accepte en paramètre un pointeur sur point. Mais p->tab[i] est le contenu d’une cellule d’un tableau d’instance de point. Une telle cellule contient une instance de point, pas un pointeur. Pour obtenir l’adresse de cette instance on doit écrire &(p->tab[i]).
Exercice de découverte F.dec.x10
Donnez les lignes de code permettant de créer une instance de poly représentant un polygone ayant trois sommets, d’assigner les coordonnées (1.0, 2.0), (2.0, 1.0), et (1.0, 1.0) à ces sommets, puis d’afficher le polygone par un appel à printPoly, puis de libérer la mémoire réservée dans le tas.
    poly* p = creePoly(3);
    setSommet(p, 0, 1.0, 2.0);
    setSommet(p, 1, 2.0, 1.0);
    setSommet(p, 2, 1.0, 1.0);
    printPoly(p);
    deletePoly(p);
F.dec4 : Copie en profondeur
Prérequis
| Sections F.dec1 et F.dec2 |
|---|
Objectif
| Dupliquer ou copier des instances de structures sans créer d’effets de bord, fuite mémoire ou accident mémoire. |
|---|
Pour illustrer la notion de copie superficielle et ses inconvénients, considérons le petit exemple suivant :
void test(void)
{
    poly* p = creePoly(3);
    setSommet(p, 0, 1.0, 2.0);
    setSommet(p, 1, 2.0, 1.0);
    setSommet(p, 2, 1.0, 1.0);
    poly* q = p;                // Ligne A
    setSommet(q ,0, 9.0, 7.0);
    printPoly(p);
    printPoly(q);
    deletePoly(p);
}
L’affichage produit est le suivant :
(9.00,7.00)(2.00,1.00)(1.00,1.00)
(9.00,7.00)(2.00,1.00)(1.00,1.00)
On constate que la modification du polygone désigné par q a impacté celui désigné par p. Et pour cause ! p et q désignent la même instance de poly.
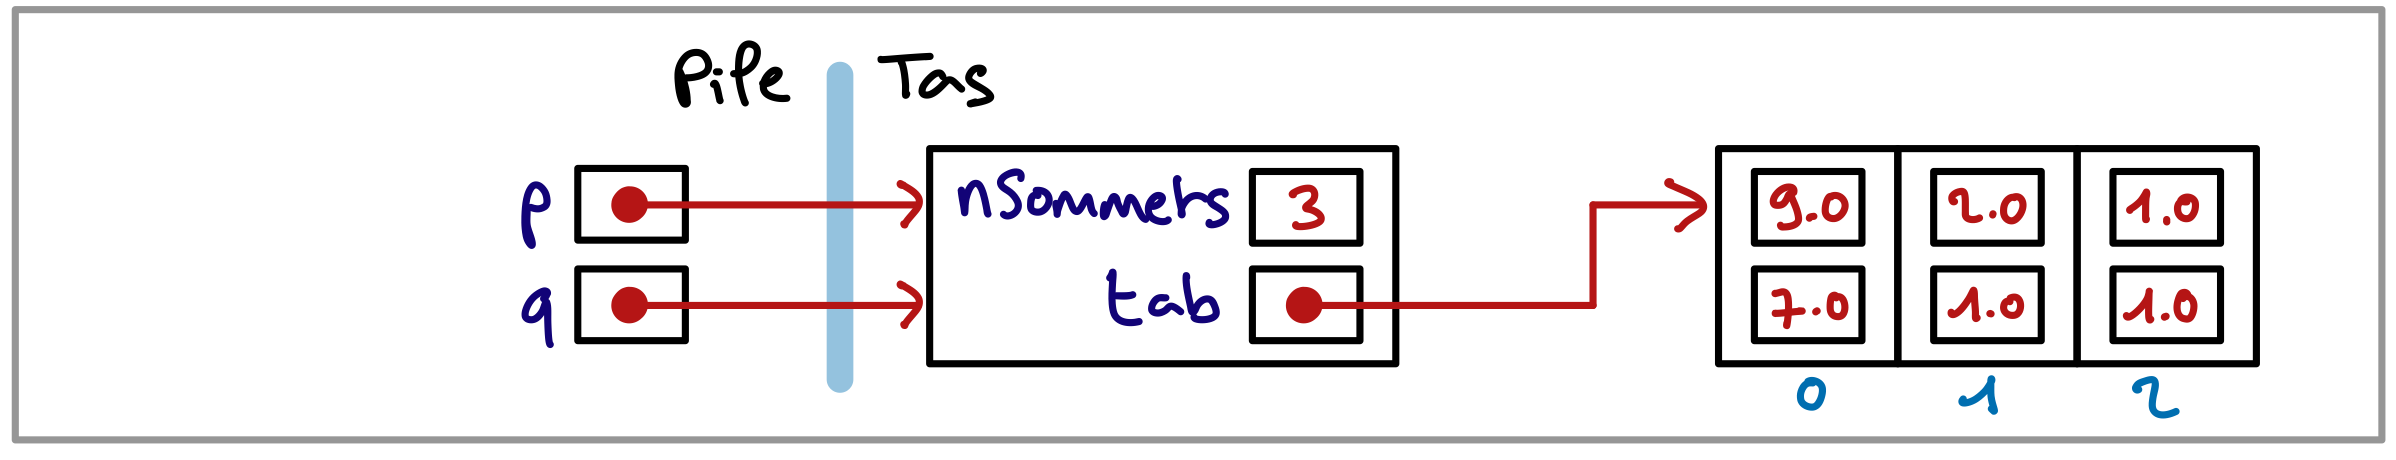
Tentons une autre approche.
void test(void)
{
    poly* p = creePoly(3);
    setSommet(p, 0, 1.0, 2.0);
    setSommet(p, 1, 2.0, 1.0);
    setSommet(p, 2, 1.0, 1.0);
    poly* q = creePoly(3);
    *q = *p;                    // Ligne A
    setSommet(q ,0, 9.0, 7.0);
    printPoly(p);
    printPoly(q);
    deletePoly(p);
    deletePoly(q);
}
Une première instance de poly est créée et son adresse est placée dans p. Ses sommets sont assignés, puis une deuxième instance de poly est créée et placée dans q. On arrive à la ligne A où l’instance de poly pointée par p est copiée par l’opérateur d’assignation = dans l’instance de poly pointée par q.
À l’exécution, on constate l’affichage suivant…
(9.00,7.00)(2.00,1.00)(1.00,1.00)
(9.00,7.00)(2.00,1.00)(1.00,1.00)
… accompagnée d’un crash du programme pour faire bonne mesure. La modification de l’instance de poly désignée par q a encore impacté celle désignée par p.
Pour expliquer ce qui c’est passé, observons la configuration en mémoire juste après l’exécution de la ligne A.
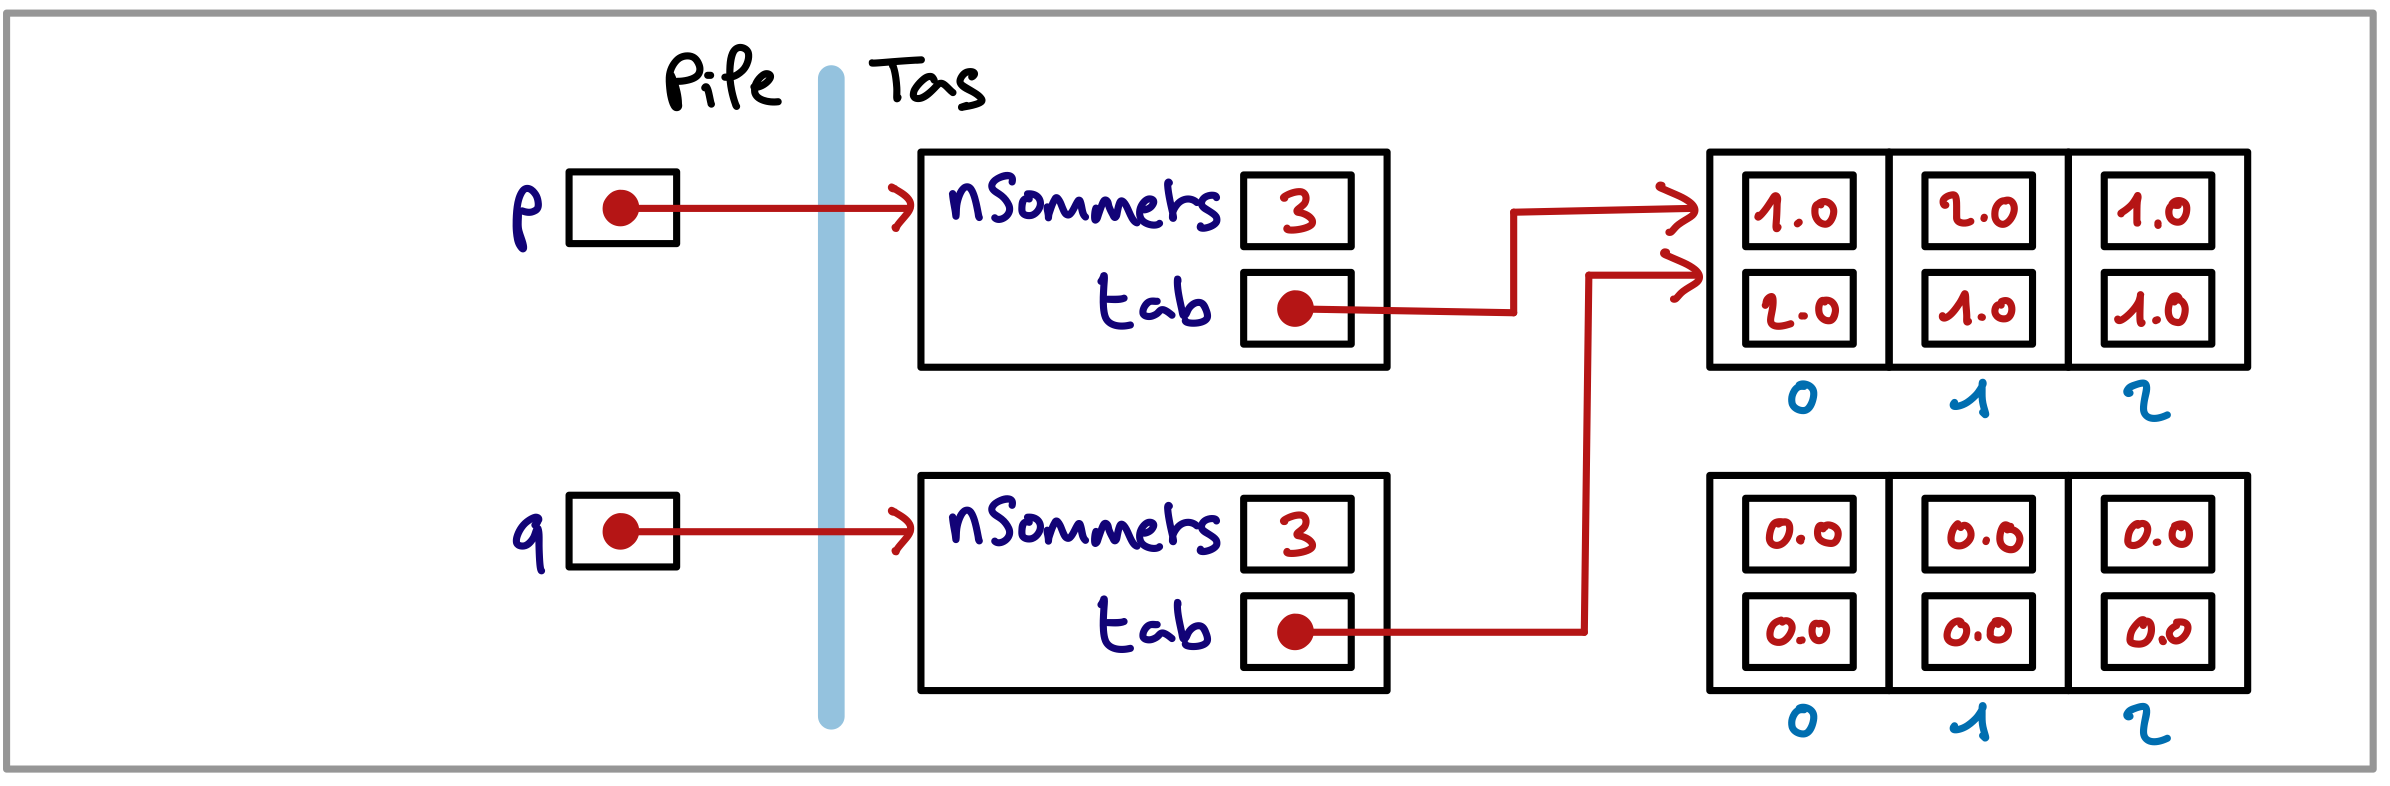
L’assignation *q = *p a recopié le contenu de l’instance de poly pointée par p dans celle pointée par q. Mais il s’agit d’une copie superficielle. Les valeurs des champs de la première instance ont été copiées dans les champs de la deuxième. Il en résulte que les champs tab des deux instances pointent le même tableau. Ceci entraîne plusieurs conséquence fâcheuses :
- Un effet de bord : toute modification d’un sommet du polygone désigné par
qimpacte celui désigné parp, puisque les points de ces deux polygones sont stockés dans le même tableau. - Une fuite mémoire, puisque la mémoire occupée pas l’ancien tableau des sommets du polygone désigné par
qn’est pas libérée. - Un accident mémoire, puisque la mémoire occupée par le tableaux de points partagé par les polygones désignés par
petqest libérée deux fois.
En conclusion, la copie d’instances de structures avec l’opérateur = fonctionne bien avec les structures monolithiques, mais pose problème avec les structures ramifiées.
Moyen
| La copie en profondeur d’une structure ramifiée. |
|---|
Nous allons à présent voir comment créer un clone d’une structure ramifiée en nous basant sur le cas de la structure poly.
Le but est de définir une fonction…
poly* clonePoly(poly* p);
…permettant de créer une nouvelle instance de poly et sa ramification en prenant comme modèle l’instance de poly désignée par p. La nouvelle instance doit être complètement indépendante de celle ayant servi de modèle. Toute modification ultérieure de l’une des deux instances ne devra avoir aucun effet sur l’autre.
Voici un exemple d’utilisation :
void test5(void)
{
    poly* p = creePoly(3);
    setSommet(p, 0, 1.0, 2.0);
    setSommet(p, 1, 2.0, 1.0);
    setSommet(p, 2, 1.0, 1.0);
    poly* q = clonePoly(p);
    setSommet(q ,0, 9.0, 7.0); // Ligne A
    printPoly(p);
    printPoly(q);
    deletePoly(p);
    deletePoly(q);
}
L’affichage attendu est :
(1.00,2.00)(2.00,1.00)(1.00,1.00)
(9.00,7.00)(2.00,1.00)(1.00,1.00)
Il montre que la modification d’un sommet du polygone désigné par q, en ligne A, n’affecte pas celui désigné par q.
Voici le code de la fonction clonePoly :
poly* clonePoly(poly* p)
{
    poly* out = creePoly(p->nSommets);
    for(int i=0; i< p->nSommets; i++)
    {
        out->tab[i] = p->tab[i];
    }
    return out;
}
Elle fait appel à la fonction creePoly pour créer un nouveau polygone, puis recopie les sommets du polygone modèle dans le tableau de stockage des sommets du nouveau polygone. Les sommets étant des instance de point, qui est une structure monolithique, il peuvent être copiés avec l’opérateur d’assignation =.
Exercice de découverte F.dec.x11
Vous devez définir une fonction…
void exgPoly(poly* p1, poly* p2);
…qui échange les polygones désignés par p1 et p2. Ce polygones n’ont pas nécessairement le même nombre de sommets. Voici un exemple de configuration en mémoire avant appel de la fonction :
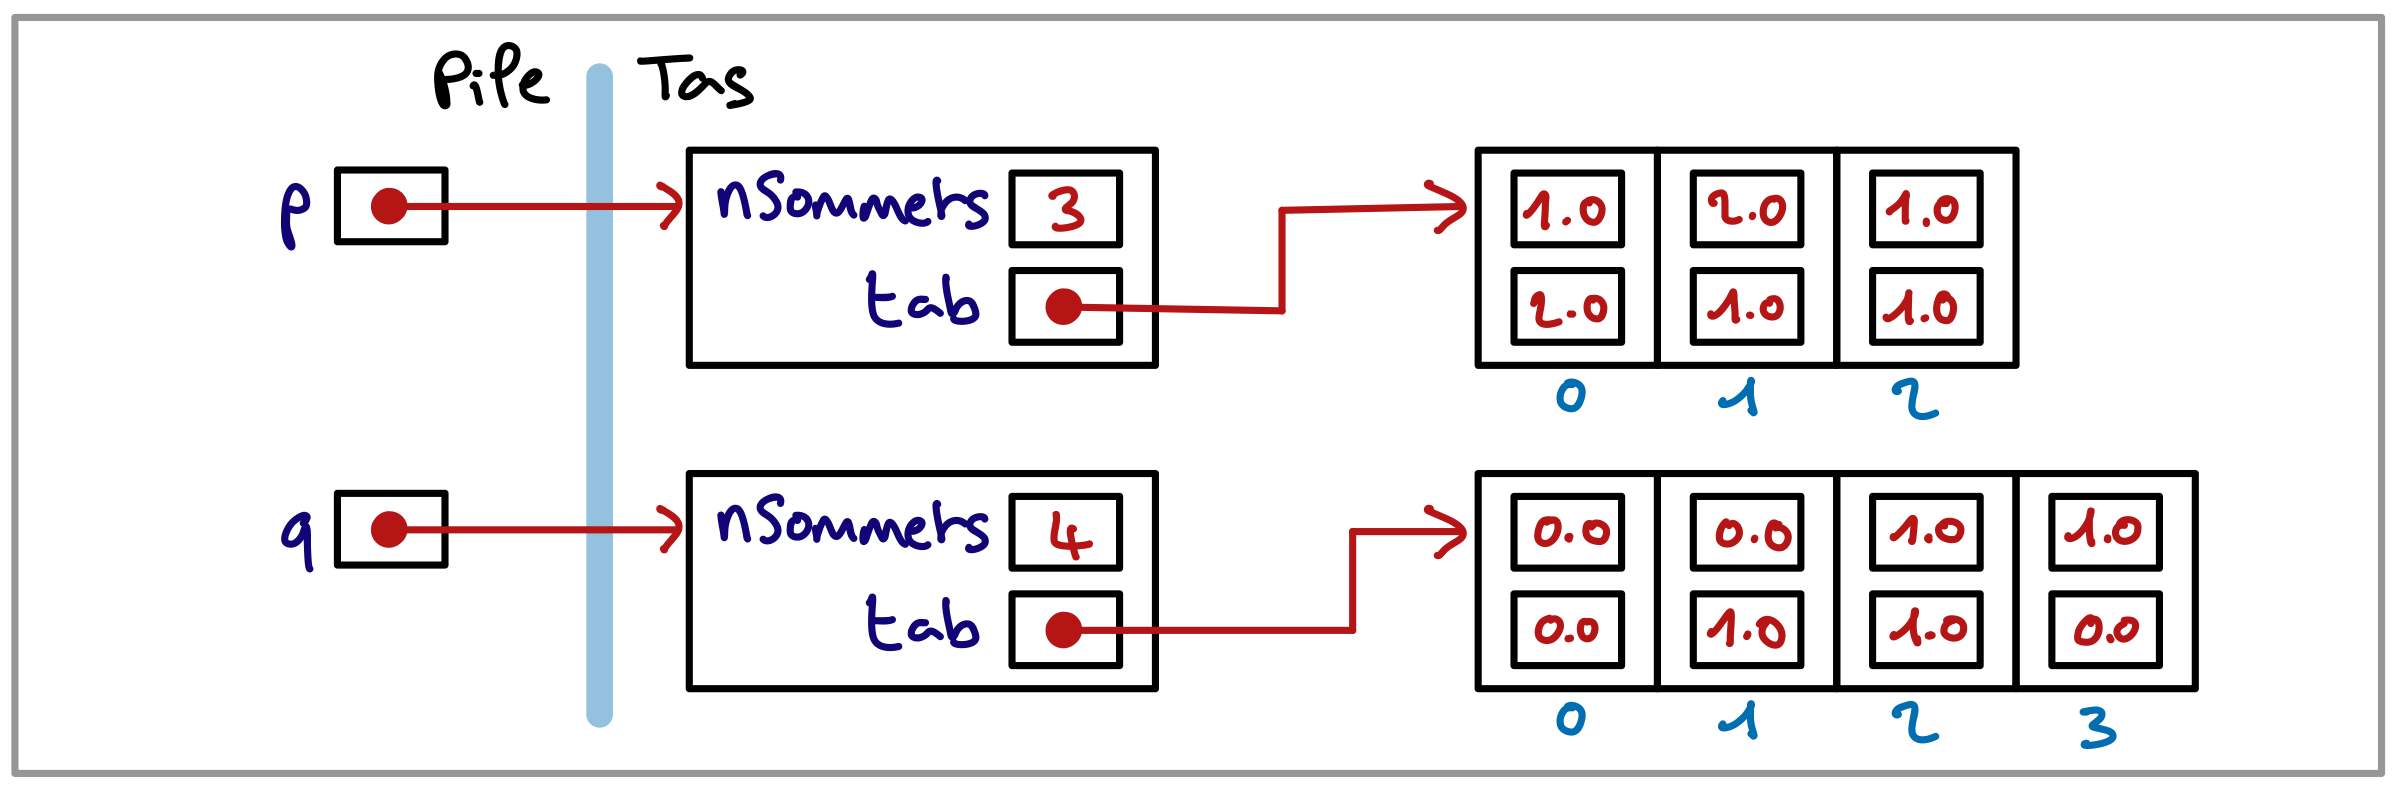
Après l’exécution de la ligne de code suivante…
exgPoly(p, q);
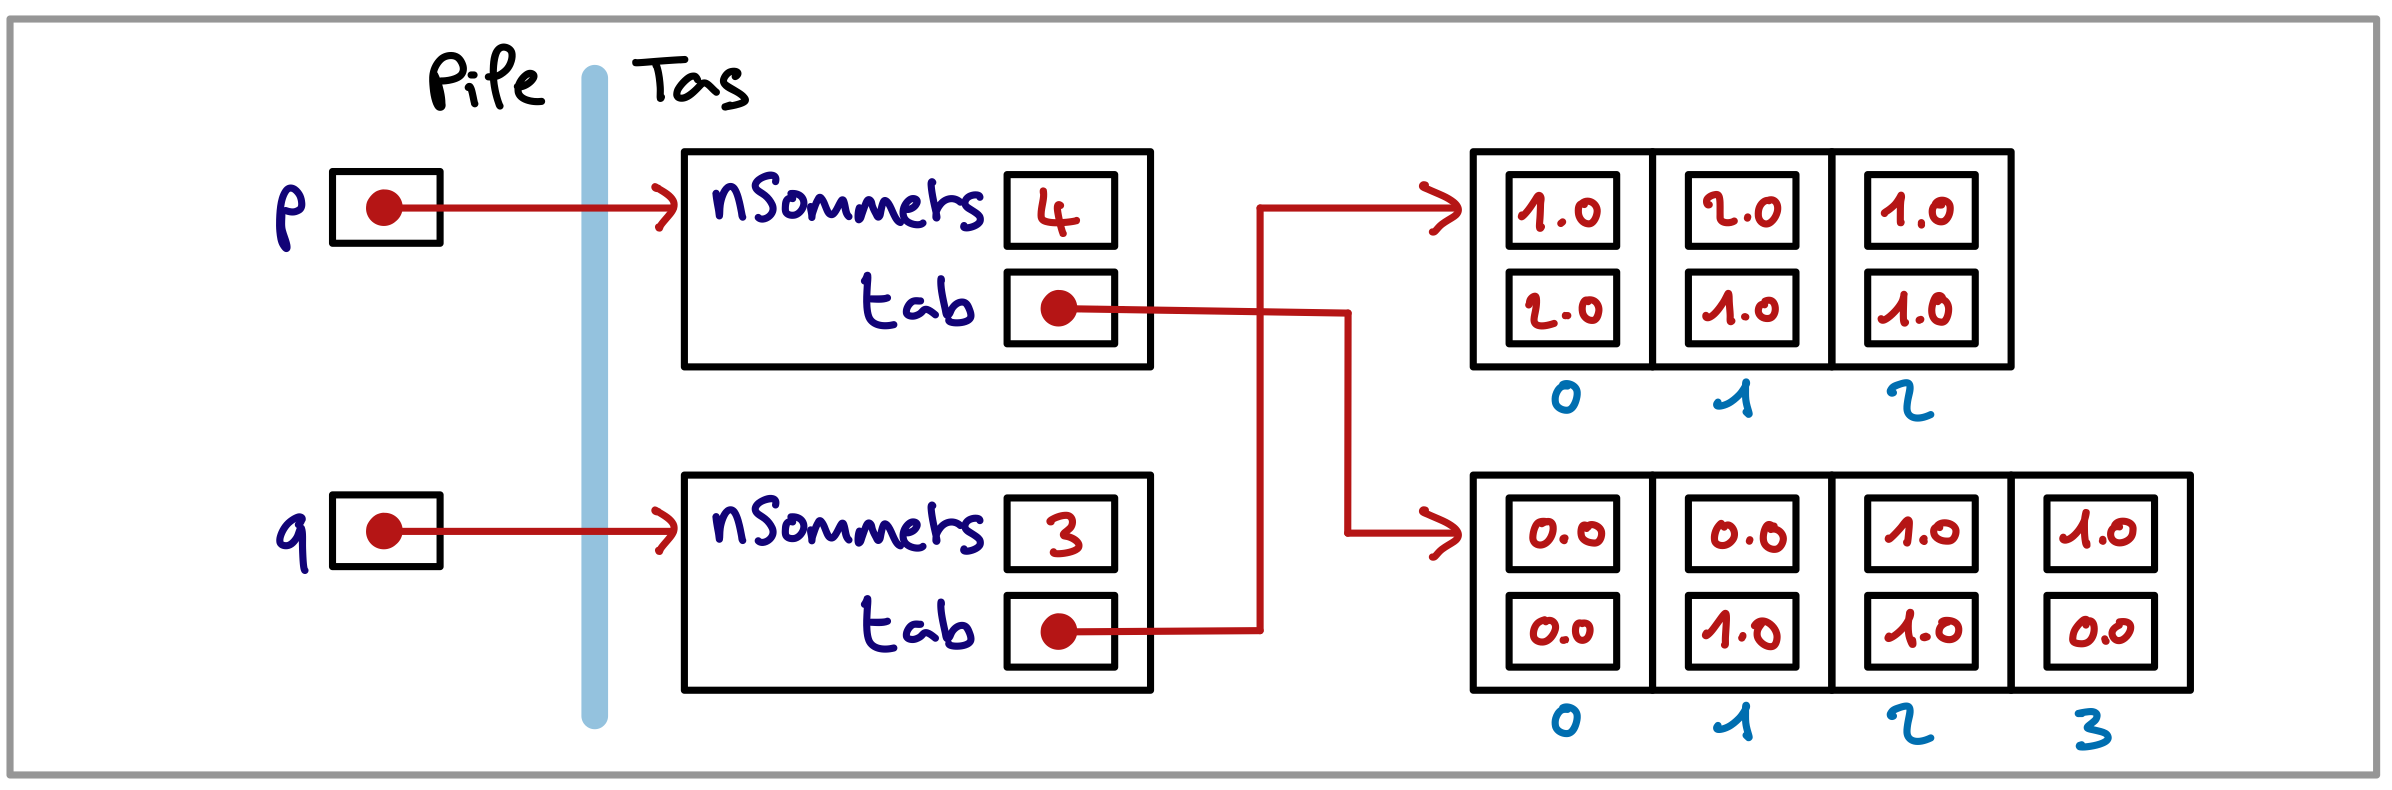
…la nouvelle situation en mémoire doit être celle-ci :
void exgPoly(poly* p1, poly* p2)
{
    poly tmp = *p1;
    *p1 = *p2;
    *p2 = tmp;
}
En général, l’utilisation de = pour copier des structures ramifiée est problématique. Mais dans ce cas particulier, comme on conserve les tableaux de stockage des deux polygones, la copie superficielle est utilisable et est même la solution la plus simple.
Mais il serait aussi possible d’écrire :
void exgPolyBis(poly* p1, poly* p2)
{
    int tmp1 = p1->nSommets;
    p1->nSommets = p2->nSommets;
    p2->nSommets = tmp1;
    point* tmp2 = p1->tab;
    p1->tab = p2->tab;
    p2->tab = tmp2;
}
Sachant que ce ne sont pas les contenus des tableaux, mais leur adresses qui sont échangées, comme le montre l’illustration précédente.
F.dec5 : Fonctions et structures
Prérequis
| Sections F.dec1, F.dec2 et F.dec3 |
|---|
Objectif
| Réaliser des fonctions qui ont des paramètres de type structure et / ou retournent des instances de structures. |
|---|
Nous avons défini et utilisé, dans la section précédente, des fonctions acceptant en paramètres des pointeurs sur des structures et / ou retournant des pointeurs sur des structures. L’utilisation de paramètres de type pointeur et de valeurs de retour de type pointeur n’était pas un concept nouveau. On peut passer des pointeurs en paramètres à des fonctions et il n’y a aucune restriction quand aux types des données pointées.
Mais contrairement aux tableaux, les structures peuvent être passées en paramètres à des fonctions par copie. Nous allons découvrir les possibilités offertes par cette nouveauté, et les limites d’utilisation raisonnable du concept.
Moyen
| Le passage en paramètre par copie et l’assignation avec = de structures monolithiques |
|---|
Revenons à la structure point définie dans la section F.dec1.
typedef struct
{
    double x;
    double y;
}point;
Dans la section F.dec3, nous avons défini une fonction permettant d’afficher les coordonnée d’un point représenté par une instance de la structure point.
void printPoint(point* p)
{
    printf("(%.02f,%.02f)", p->x, p->y);
}
Cette fonction a un paramètre de type pointeur sur point. On doit donc lui passer en argument l’adresse d’une instance de point, et c’est la raison pour laquelle les notations p->x et p->y sont utilisées pour récupérer les valeurs des coordonnées à afficher.
Mais il est possible de réaliser une variante de cette fonction qui a un paramètre de type point.
void displayPoint(point p)
{
    printf("(%.02f,%.02f)", p.x, p.y);
}
Les deux fonctions ne s’appellent pas de la même manière, puisque leur paramètres ont des types différents. Voici un exemple :
    point w ={3.5, 2.0};
    printPoint(&w);
    printf(" ");
    displayPoint(w);
    printf("\n");
L’argument de l’appel à printPoint est l’adresse de l’instance de point contenue dans w.
L’argument de l’appel à displayPoint est l’instance de point contenue dans w. Plus précisément, cette instance de point est recopiée dans le paramètre p de la fonction displayPoint.
Le fait de pouvoir passer une instance de structure en paramètre par copie à une fonction peut permettre de simplifier la définition et l’utilisation de cette fonction, au prix d’une légère perte d’efficacité. En effet, un pointeur et une instance de point n’ont pas la même taille en mémoire. Si on exécute la ligne suivante…
printf("%ld, %ld\n", sizeof(point*), sizeof(point));
…on obtient l’affichage :
8, 16
Sur la machine utilisée pour faire l’expérience, un pointeur sur point occupe 8 octets en mémoire alors qu’une instance de point en occupe 16.
Lors de l’appel à printPoint, 8 octets sont recopiés dans son paramètre, alors que lors de l’appel de displayPoint ce sont 16 octets qui sont copiés, ce qui augmente à la fois le temps CPU et la quantité de mémoire consommés.
Exercice de découverte F.dec.x12
On définit une structure couple représentant des couples constitués de deux points.
typedef struct
{
    point a;
    point b;
}couple;
Définissez une fonction…
void displayCouple(couple w);
… qui affiche un couple en appelant la fonction displayPoint.
void displayCouple(couple w)
{
    printf("[");
    displayPoint(w.a);
    printf(",");
    displayPoint(w.b);
    printf("]");
}
Exercice de découverte F.dec.x13
Définissez une fonction…
void printCouple(couple* w);
… qui affiche un couple en appelant la fonction printPoint.
void printCouple(couple* w)
{
    printf("[");
    printPoint(&(w->a));
    printf(",");
    printPoint(&(w->b));
    printf("]");
}
Faites attention à ne pas vous empêtrer dans le syntaxe. Comme w pointe une instance de couple, on accède au champ a de cette instance avec la notation w->a. Mais comme le champ a contient une instance de point (et non un pointeur), il faut utiliser la notation &(w->a) pour obtenir l’adresse de cette instance de point.
Non seulement une fonction peut avoir des paramètres de type structure, mais elle peut également retourner une valeur de type structure, c’est à dire une instance de structure.
Par exemple, la fonction suivante retourne le milieu du segment ayant pour extrémités les deux points représentés par ses paramètres e1 et e2 :
point milieu(point e1, point e2)
{
    point m;
    m.x = (e1.x + e2.x) / 2.0;
    m.y = (e1.y + e2.y) / 2.0;
    return m;
}
Cette fonction crée une nouvelle instance de point, la « garnit » avec les coordonnées du milieu du segment, puis retourne une copie de cette instance de point. La variable locale m est détruite à l’issue de l’exécution de la fonction milieu, mais une copie de sa valeur est retournée et peut être récupérée dans une variable, comme dans l’exemple suivant :
    point pt1 = {1.0, 2.0};
    point pt2 = {3.0, 4.0};
    point m = milieu(pt1, pt2);
    displayPoint(m);
On peut même écrire :
displayPoint(milieu(pt1, pt2));
Dans ce cas, l’instance de point retournée par milieu est transmise directement à displayPoint.
Exercice de découverte F.dec.x14
Définissez la fonction…
point mil(couple c);
…qui retourne l’instance de point représentant le milieu du segment ayant pour extrémités les points du couple désigné par c. La fonction mil doit appeler la fonction milieu précédemment définie.
Voici une solution simple et concise :
point mil(couple c)
{
    return milieu(c.a, c.b);
}
Mais on peut aussi écrire :
point mil(couple c)
{
    point m = milieu(c.a, c.b);
    return m;
}
En résumé :
- Les fonctions à paramètres de type structure sont un peu plus faciles à utiliser et à implémenter que les fonctions à paramètres de type pointeurs sur des structures, mais leur exécution est un peu moins efficace, ce qui n’est pas nécessairement un problème.
- Les fonctions retournant des structures ont le même avantage et le même défaut. Elle permettent aussi souvent de simplifier le code source d’un programme et leur utilisation ne pose aucun problème à part un légère perte d’efficacité.
Mais attention, l’utilisation de fonctions retournant des instances de structures ramifiées peut poser problème. Ce point ne sera pas développé (mais vous pouvez réfléchir à la question par vous-même). Dans la suite, nous éviterons de définir de telles fonctions.
F.dec6 : Compléments
Le concept de structure présenté dans cette partie ouvre de très nombreuses possibilités. Il est difficile d’être exhaustif sur le sujet et je n’ai pas cet objectif. Il y a toutefois deux choses importantes qui n’ont pas encore été abordées : les variantes de syntaxe et la comparaison d’instances de structures.
Variantes de déclarations de structures
Il existe une autre syntaxe que celle présentée plus haut pour la déclaration de structures, que nous appellerons « forme ancienne ».
La déclaration…
struct spoint
{
    double x;
    double y;
};
… définit le type struct spoint. À l’utilisation, il faut à chaque fois écrire struct spoint. On peut ensuite écrire…
typedef struct spoint point;
… pour définir une notation raccourcie point équivalente à struct point..
La déclaration vue en début de cette partie…
typedef struct
{
    double x;
    double y;
}point;
…est en quelques sorte une contraction des deux déclarations précédentes.
La forme ancienne n’a d’intérêt que lors de la déclaration de structures autoréférentes, c’est à dire de structures ayant un champ de type pointeur sur leur propre type. Comme nous n’aborderons pas ce sujet, nous utiliseront toujours la forme simplifiée.
Comparaison d’instances de structures
Nous avons vu que les instances de structures peuvent être copiées avec l’opérateur d’assignation =. Par contre elles ne peuvent pas êtres comparées avec == ou !=, >, <, etc.
Par exemple, on pourrait avoir besoin de comparer des instances de la structure date définie dans le section F.dec1.
typedef struct
{
    char jour;
    char mois;
    int annee;
}date;
Mais si d1 et d2 sont des variables de type date, on ne peut écrire quelque chose dans le genre :
    if(d1==d2)
    {
        ……………
    }
Pour comparer des instances d’un type structure, il faut définir une fonction spécifique.
Exercice de découverte F.dec.x15
Définissez une fonction…
int compareDate(date d1, date d2);
… qui retourne un entier négatif si la date désignée par d1 est antérieure à celle désignée par d2, une valeur positive si la date désignée par d1 est postérieure à celle désignée par d2, et la valeur 0 si les deux dates sont identiques.
Remarque : si les années sont différentes, nul besoin de prendre en compte les jours et les mois pour conclure. Si les années sont identiques et les mois différents, nul besoin de comparer les jours. Si les années et les mois sont identiques, le résultat dépend uniquement des jours.
int compareDate(date d1, date d2)
{
    if(d1.annee != d2.annee) return d1.annee - d2.annee;
    else if(d1.mois != d2.mois) return d1.mois - d2.mois;
    else return d1.jour - d2.jour;
}
Activité d’entraînement F.ent
Cette activité est essentielle. C’est grâce à elle que vous apprendrez vraiment à comprendre et utiliser les notions vues précédemment. Elle se décompose en plusieurs itérations : ent1, ent2, etc.
Vous devez réaliser au moins une itération et évaluer votre niveau de réussite par une valeur entre 1 et 4 selon les critères habituels. L’itération que vous avez traité le plus récemment est appelée itération courante. On appelle itération suivante celle qui suit l’itération courante, excepté si l’itération courante est la dernière disponible, auquel cas l’itération suivante est la première itération.
Si le résultat est 1, vous devrez traiter à nouveau l’activité de découverte précédente, en laissant passer au moins une nuit, avant de revenir à cette activité d’entraînement en réalisant à nouveau l’itération courante. Vous devez aussi essayer d’identifier les points de blocage et demander à votre enseignant de vous aider à les surmonter.
Si le résultat est 2, vous devrez d’abord comprendre ce qui vous a conduit à des erreurs et / ou ce qui vous a bloqué. Si vous avez des doutes, des difficultés, essayez de trouver les réponses dans les présentations et explication de l’activité de découverte précédente et demandez toute l’aide nécessaire à votre enseignant. Ensuite, vous devrez réaliser l’itération suivante de l’activité d’entraînement actuelle après un délai d’au moins deux jours et d’au plus une semaine.
Si le résultat est 3, vous devrez revenir traiter l’itération suivante après un délai de plusieurs semaines.
En traitant les exercices, vous devrez considérer que les paramètres des fonctions ont des valeurs correctes. Il ne vous est pas demandé de vérifier si certaines valeurs sont aberrantes au regard de ce que demande l’énoncé. Par exemple, si un paramètre doit être positif pour que le traitement demandé soit possible, vous considérerez que la fonction sera appelée avec une valeur positive de ce paramètre.
Vous pouvez utiliser un ordinateur pour tester vos solutions et les corriger en cas de comportement inattendu. C’est même recommandé, à condition de commencer par réfléchir avant de vous jeter sur le clavier. Si vous pensez avoir une solution différente de celle proposée, ce qui peut arriver souvent, vous ne devez en aucun cas rester dans le doute. Vous devez vérifier si votre solution est correcte ou non, soit en testant votre solution avec un ordinateur, soit en demandant à une personne enseignante.
Itération F.ent1
Exercice d’entrainement F.ent1.1
On reprend la structure point :
typedef struct
{
    double x;
    double y;
}point;
Vous devez définir une fonction…
point sym(point w);
…retournant le point symétrique de celui désigné par le paramètre w. Le symétrique d’un point est obtenu en échangeant ses coordonnées (x) et (y).
point sym(point w)
{
    point out;
    // À compléter
    return out;
}
point sym(point w)
{
    point out;
    out.x = w.y;
    out.y = w.x;
    return out;
}
Vous devez définir la variante suivante de fonction sym, qui retourne le symétrique du point désigné par p :
point sym1(point* p);
point sym1(point* p)
{
    point out;
    out.x = p->y;
    out.y = p->x;
    return out;
}
Donnez les lignes de code permettant :
- De déclarer une variable
p1de typepointinitialisée avec une instance depointreprésentant le point de coordonnées \((1.0,3.0)\). - De placer dans une variable
p2de typepointune instance depointreprésentant le symétrique du point représenté par le contenu dep1, produit par un appel à la fonctionsym. - De placer dans une variable
p3de typepointune instance depointreprésentant le symétrique du point représenté par le contenu dep2, produit par un appel à la fonctionsym1. - D’afficher la valeur de
p3à l’aide de la fonctiondisplayPoint. - D’afficher la valeur de
p3à l’aide de la fonctionprintPoint.
Pour mémoire, voici les déclarations des fonctions d’affichage :
void printPoint(point* p)
void displayPoint(point p)
    point p1 = {1.0, 3.0};
    point p2 = sym(p1);
    point p3 = sym1(&p2);
    displayPoint(p3);
    printPoint(&p3);
Exercice d’entrainement F.ent1.2
On définit la structure suivante représentant un point informé, c’est à dire un point ayant un nom représenté par une chaîne.
typedef struct
{
    point pt;
    char* nom;
}iPoint;
Définissez la fonction…
iPoint* creePoint(double x, double y, const char* nom);
…permettant de créer une instance de iPoint et sa ramification (la chaine contenant le nom du point) située complètement dans le tas. Une telle instance, avec sa ramification, est constituée de deux blocs mémoire. La chaîne contenant le nom du point créé doit être une copie de la chaîne désignée par le paramètre nom.
Voici une solution partielle, à compléter :
iPoint* creePoint(double x, double y, const char* nom)
{
    iPoint* out = (iPoint*)malloc(sizeof(iPoint));
    // À compléter
    return out;
}
Il reste à :
- Placer les valeurs
xetydans les champsxetyde l’instance de structure pointée parout. - Réserver un bloc mémoire destiné à recevoir la copie la chaîne représentant le nom du point.
- Recopier cette chaîne dans ce bloc mémoire.
iPoint* creePoint(double x, double y, const char* nom)
{
    iPoint* out = (iPoint*)malloc(sizeof(iPoint));
    out->pt.x = x;
    out->pt.y = y;
    out->nom = (char*)malloc(1+(strlen(nom)*sizeof(char)));
    strcpy(out->nom,nom);
    return out;
}
Définissez la fonction…
iPoint* clonePoint(iPoint* m);
…permettant de cloner l’instance de iPoint désignée par m. Comme il se doit pour un clone, l’instance produite doit être identique à l’originale mais complètement indépendante en mémoire. Vous devez utiliser la fonction creePoint afin de simplifier au maximum le code.
iPoint* clonePoint(iPoint* m)
{
    iPoint* out = creePoint(m->pt.x, m->pt.y, m->nom);
    return out;
}
Définissez la fonction…
int compare(iPoint* p1, iPoint* p2);
…qui retourne vrai (1) si les coordonnées des points désignés par p1 et p2 sont identiques et faux (0) dans le cas contraire. Cette fonction de comparaison ne tient pas compte des noms des points.
int compare(iPoint* p1, iPoint* p2)
{
    return (p1->pt.x == p2->pt.x) && (p1->pt.y == p2->pt.y);
}
Définissez la fonction…
void deletePoint(iPoint* p);
…qui libère toute la mémoire occupée par l’instance de iPoint (avec sa ramification) désignée par p.
void deletePoint(iPoint* p)
{
    free(p->nom);
    free(p);
}
Définissez la fonction…
void printIpoint(iPoint* p);
…qui affiche une instance de iPoint avec un format similaire à l’exemple suivant (le nom du point est entre crochets) :
(3.00,5.00)[Point 1]
Cette fonction doit appeler la fonction…
void printPoint(point* p);
…qui affiche une instance de point.
void printIpoint(iPoint* p)
{
    printPoint(&(p->pt));
    printf ("[%s]\n", p->nom);
}
Donnez les lignes de code permettant de :
- Créer une instance de
iPointde coordonnées \((3.0,5.0)\) et placer son adresse dans une variablep1. - Créer un clone de cette instance et placer son adresse dans une variable
p2. - Comparer ces deux instances avec la fonction
compareet afficherOKsi les instances représentent des points de mêmes coordonnées. - Afficher l’instance désignée par
p1à l’aide de la fonctionprintIpoint. - Libérer la mémoire occupée par les deux instances de
iPoint.
    iPoint* p1 = creePoint(3.0, 5.0, "Point 1");
    iPoint* p2 = clonePoint(p1);
    if(compare(p1,p2)) printf("OK\n");
    printIpoint(p1);
    deletePoint(p1);
    deletePoint(p2);
Exercice d’entrainement F.ent1.3
Dans cet exercice, on utilise la structure date vue précédemment :
typedef struct
{
    char jour;
    char mois;
    int annee;
}date;
La fonction suivante permet d’afficher une instance de date :
void displayDate(date d)
{
    printf("%02d/%02d/%d ", d.jour, d.mois, d.annee);
}
La structure suivante représente une pile de dates :
typedef struct
{
    int capa;
    int top;
    date* data;
}pileDates;
Les champs ont les rôles suivants :
capa: capacité de la pile, i.e., nombre de dates pouvant être empilées.top: sommet de la pile, i.e., indice de la première case libre du tableau de stockage.data: pointe le tableau de stockage dans lequel se trouvent les dates empilées.
Les fonctions permettant d’exploiter cette structure de donnée sont les suivantes :
pileDates* creePileD(int capa): Crée une pile de date de capacitécapa, située entièrement dans le tas.void deletePile(pileDates* p): Libère toute la mémoire utilisée par la pile de dates désignée parp.void push(pileDates* p, date d): Empile la dateddans la pile de dates désignée parp. Si la pile est pleine, sa capacité est augmentée de 10.date pop(pileDates* p): Dépile une instance dedatede la pile désignée parp, dont la taille (mais pas la capacité) diminue de 1. La pile est censée contenir au moins une date. Aucune vérification n’est faite.void pushJMA(pileDates* p, int j, int m, int a): Empile la date constituée du jourj, du moismet de l’annéeadans la pile désignée parp.
Commencez par définir la fonction creePileD.
pileDates* creePileD(int capa)
{
    pileDates* out = (pileDates*)malloc(sizeof(pileDates));
    // À compléter
    return out;
}
Il reste à initialiser les trois champs de l’instance de structure pileDate pointée par out.
pileDates* creePileD(int capa)
{
    pileDates* out = (pileDates*)malloc(sizeof(pileDates));
    out->top =0;
    out->capa = capa;
    out->data = (date*)malloc(capa*sizeof(date));
    return out;
}
Définissez la fonction deletePile.
void deletePile(pileDates* p)
{
    free(p->data);
    free(p);
}
Définissez la fonction push.
void push(pileDates* p, date d)
{
    if(p->top == p->capa)
    {
        // À compléter
    }
    p->data[p->top] = d;
    p->top++;
}
La partie à compléter doit agrandir le tableau de stockage des dates empilée en utilisant la fonction realloc.
void push(pileDates* p, date d)
{
    if(p->top == p->capa)
    {
        p->capa = p->capa + 10;
        p->data = realloc(p->data, p->capa*sizeof(date));
    }
    p->data[p->top] = d;
    p->top++;
}
Définissez la fonction pop.
date pop(pileDates* p)
{
    p->top--;
    return p->data[p->top];
}
Définissez la fonction pushJMA (en utilisant push).
void pushJMA(pileDates* p, int j, int m, int a)
{
    date d = {j, m, a};
    push(p, d);
}
Donnez les lignes de code permettant de :
- Créer une pile de dates pointée par une variable
pile. - Empiler deux dates (de votre choix) dans cette pile en utilisant la fonction
pushJMA. - Dépiler une date, l’afficher, puis dépiler l’autre et l’afficher.
- Libérer toute la mémoire occupée dans le tas par la pile de date.
    pileDates* pile = creePileD(10);
    pushJMA(pile, 1, 2, 1986);
    pushJMA(pile, 14, 9, 1987);
    date d = pop(pile);
    displayDate(d);
    d = pop(pile);
    displayDate(d);
    deletePile(pile);
Itération F.ent2
Exercice d’entrainement F.ent2.1
On définit la structure suivante ayant pour rôle d’encapsuler des chaines de manière à faciliter leur utilisation.
#define MAX_SIZE 100

typedef struct
{
    char data[MAX_SIZE+1];
}eString;
Une instance de eString contient une chaîne représentée de manière standard par une suite de caractères suivie du marqueur de fin 0. Sa longueur maximum est définie par la constante MAX_SIZE.
L’intérêt d’encapsuler un tableau dans une structure est que les instances d’une telle structure peuvent être passées en paramètres en copie à des fonctions et retournées par des fonctions, ce que qui n’est pas réalisable directement avec des tableaux.
Vous devez réaliser une fonction…
eString creeString(char* str)
…qui retourne une instance de eString contenant la chaîne désignée par le paramètre str.
Par exemple, l’exécution des lignes de code suivantes…
    eString s = creeString("Bonjour");
    printf("%s\n", s.data);
…doit produire l’affichage :
Bonjour
eString creeString(char* str)
{
    eString out;
    strcpy(out.data, str);
    return out;
}
Définissez une fonction…
eString concat(eString s1, eString s2);
…qui retourne une chaine encapsulée contenant la concaténation des deux chaines encapsulées désignée par s1 et s2.
Par exemple, l’exécution des lignes de code suivantes…
    eString s = creeString("aaa");
    eString t = creeString("bbb");
    s = concat(s, t);
    printf("%s %s\n", s.data, t.data);
…doit produire l’affichage :
aaabbb bbb
On suppose que la taille du résultat de la concaténation est inférieure ou égale à MAX_SIZE.
eString concat(eString s1, eString s2)
{
    eString out;
    // À compléter
    return out;
}
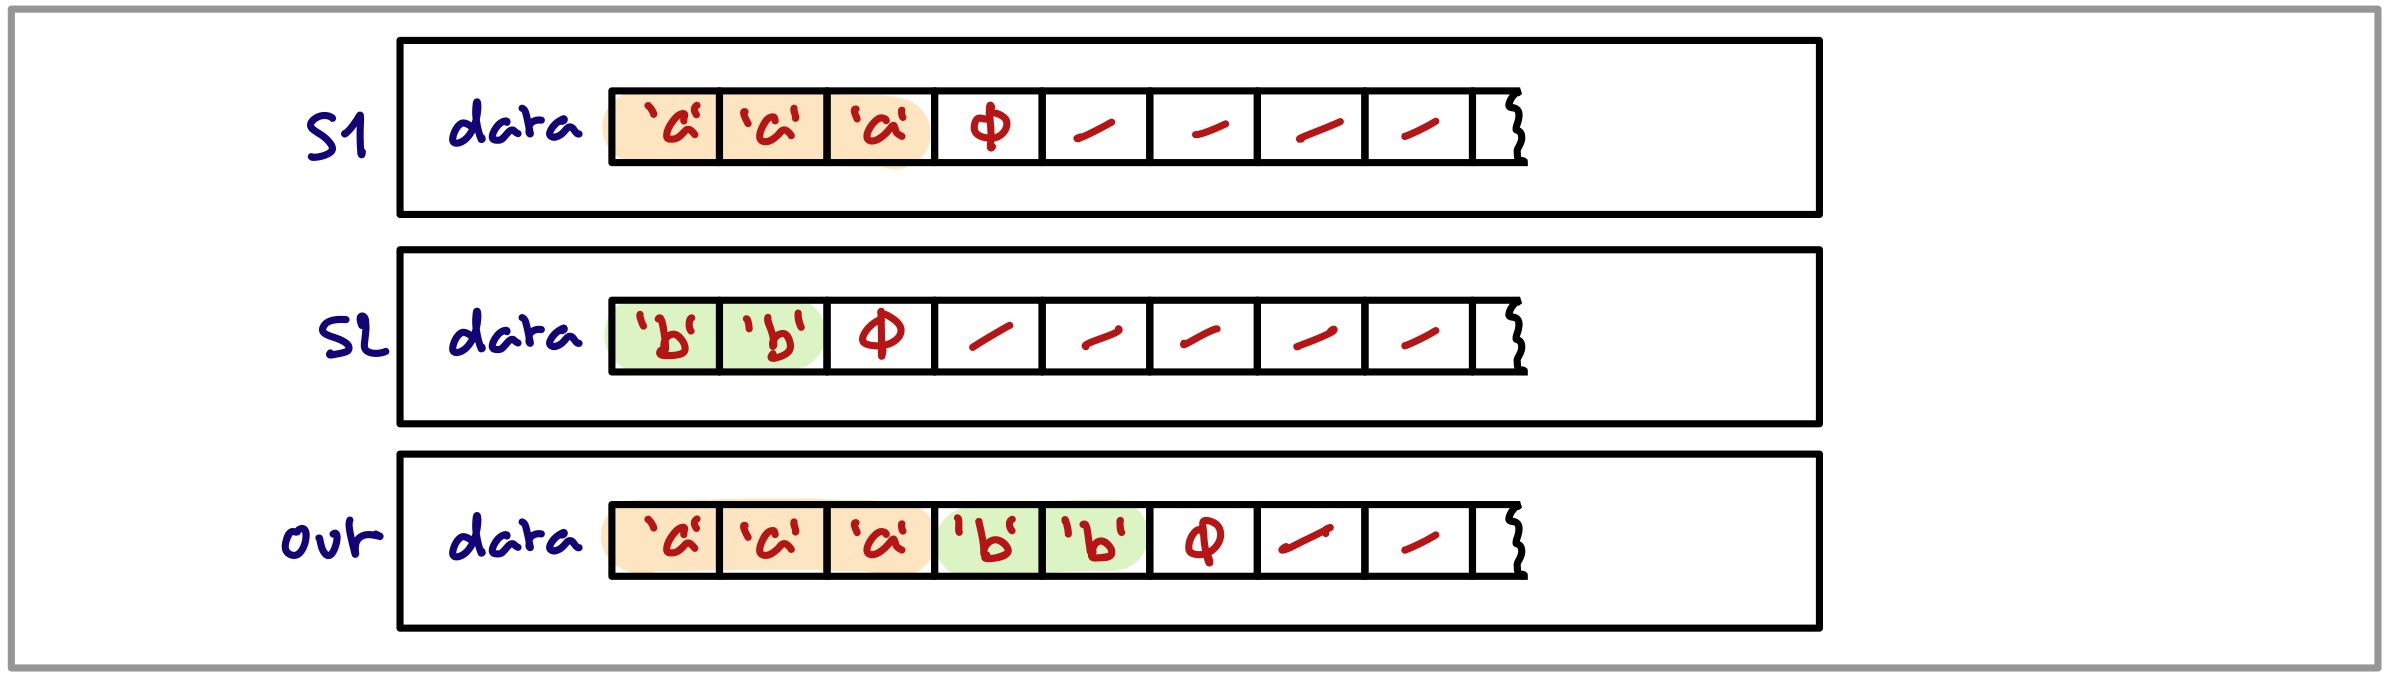
Il reste à copier la chaîne contenue dans l’instance de eString désignée par s1 dans celle désignée par out (avec strcpy), puis de concaténer à cette chaîne (avec strcat) la chaîne contenue dans l’instance de eString désignée par s2.
eString concat(eString s1, eString s2)
{
    eString out;
    strcpy(out.data,s1.data);
    strcat(out.data,s2.data);
    return out;
}
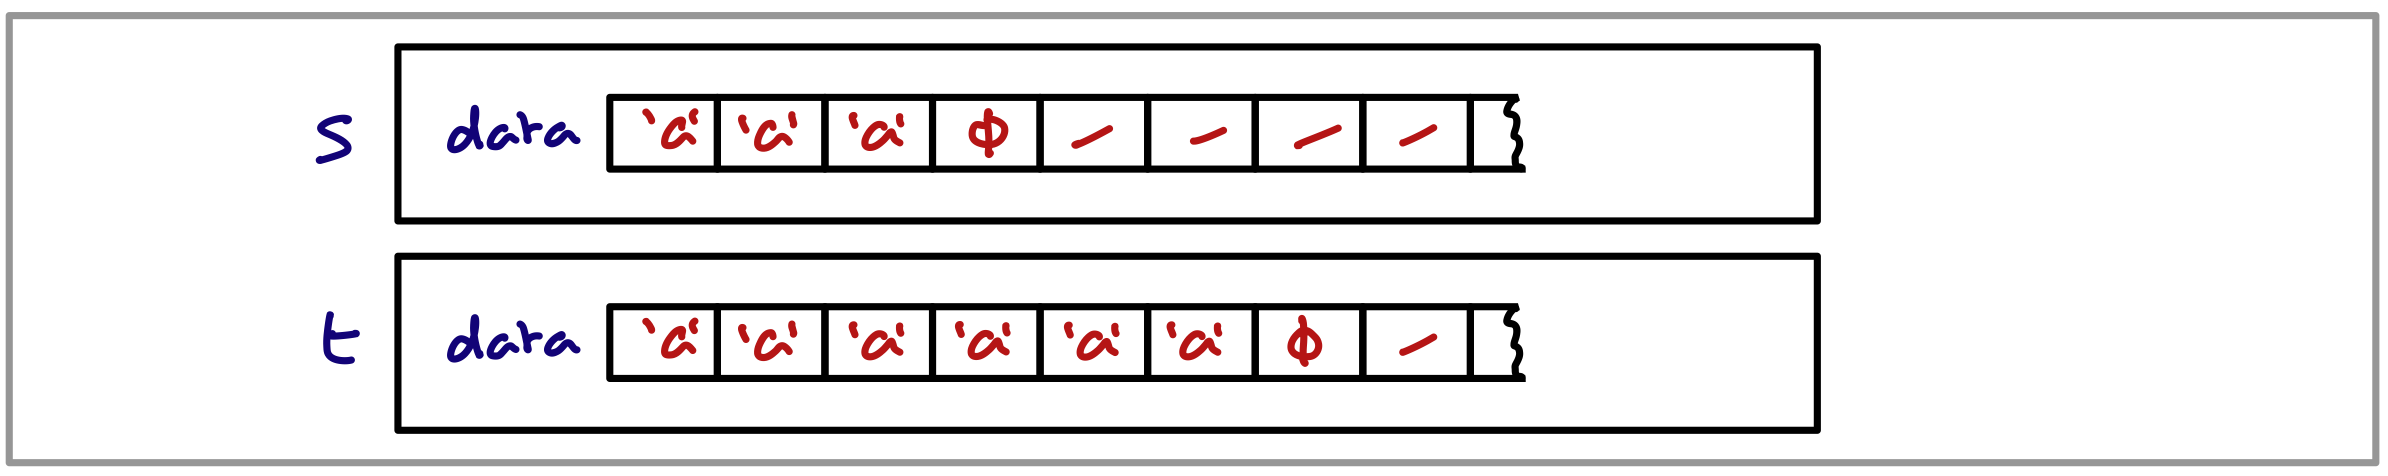
Dessinez la situation en mémoire à l’issue de l’exécution des lignes de code suivantes :
    eString s = creeString("aaa");
    eString t = concat(s,s);
Exercice d’entrainement F.ent2.2
On reprend le concept de chaîne encapsulée dans une structure de l’exercice précédent, mais avec une structure ramifiée basée sur le type suivant :
typedef struct
{
    char* data;
}rString;
Définissez la fonction…
rString* creeRstring(char* str);
… permettant de créer une instance de rString située (avec sa ramification) entièrement dans le tas et contenant une copie de la chaîne désignée par le paramètre str.
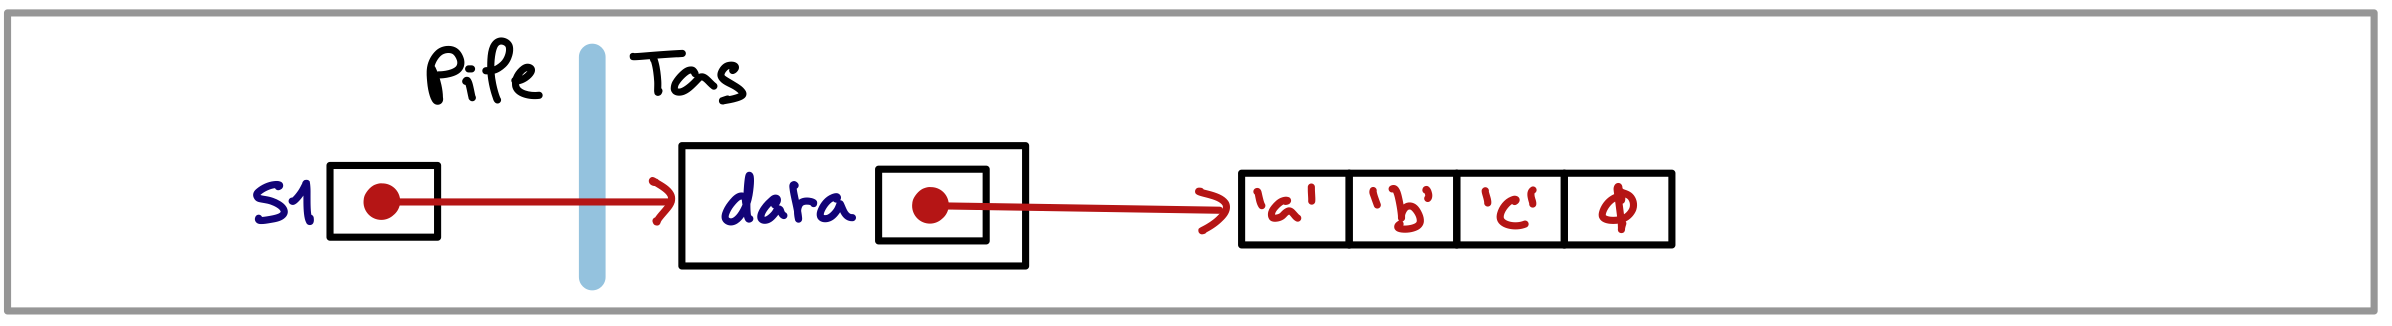
Par exemple, la ligne de code…
rString* s1 = creeRstring("abc");
…doit produire la situation en mémoire suivante :
rString* creeRstring(char* str)
{
    rString* out = (rString*)malloc(sizeof(rString));
    // À compléter
    return out;
}
Il reste à :
- Réserver le bloc mémoire pour stocker la chaîne qui sera pointée par le champ
data. - Recopier la chaînes désignée par str dans ce bloc mémoire.
rString* creeRstring(char* str)
{
    rString* out = (rString*)malloc(sizeof(rString));
    out->data = (char*)malloc(1+(sizeof(char)*strlen(str)));
    strcpy(out->data, str);
    return out;
}
Définissez une fonction…
rString* concatR(rString* s1, rString* s2);
…qui produit une nouvelle chaîne encapsulée représentant la concaténation de contenus des chapînes encapsulées désignées par s1 et s2. La chaîne encapsulée produite ne doit être complètement indépendante en mémoire des chaînes encapsulées désignées par s1 et s2.
rString* concatR(rString* s1, rString* s2)
{
    rString* out = (rString*)malloc(sizeof(rString));
    int n = (int)strlen(s1->data) + (int)strlen(s2->data) +1;
    // À compléter
    return out;
}
Il manque :
- La réservation du bloc mémoire permettant de stocker les caractères de la chaîne à produire.
- La copie dans ce bloc du contenu de la chaîne encapsulée désignée par
s1. - La concaténation dans ce même bloc du contenu de la chaîne désignée par
s2.
rString* concatR(rString* s1, rString* s2)
{
    rString* out = (rString*)malloc(sizeof(rString));
    int n = (int)strlen(s1->data) + (int)strlen(s2->data) +1;
    out->data = (char*)malloc(1+(sizeof(char)*n));
    strcpy(out->data, s1->data);
    strcat(out->data, s2->data);
    return out;
}
Définissez la fonction…
void deleteRstring(rString* t);
…permettant de libérer la mémoire occupée dans le tas par une instance de rString avec sa ramification.
void deleteRstring(rString* t)
{
    free(t->data);
    free(t);
}
Quand on exécute la fonction de test suivante…
void test(void)
{
    rString* s1 = creeRstring("abc");
    rString* s2 = concatR(s1, creeRstring("def"));
    printf("%s\n", s2->data);
    deleteRstring(s1);
    deleteRstring(s2);
}
… on obtient l’affichage :
abcdef
L’exécution se passe sans encombre, et pourtant il y a une erreur dans cette fonction. Trouvez-là et proposez une version corrigée.
Lors le l’exécution de cette fonction, il y a deux appels à creeRstring et un appel à concatR. Au total, combien de blocs mémoire sont réservés par ces appels ? Combien sont libérés ?
Les blocs mémoire constituant l’instance ramifiée produite par le deuxième appel de creeRstring ne sont jamais libérés. Il y a donc une fuite mémoire. Trouvez un moyen de l’éviter.
void test9(void)
{
    rString* s1 = creeRstring("abc");
    rString* tmp = creeRstring("def");
    rString* s2 = concatR(s1, tmp);
    deleteRstring(tmp);
    printf("%s\n", s2->data);
    deleteRstring(s1);
    deleteRstring(s2);
}
Ce type de problème ne se pose pas avec la version monolithique des chaînes encapsulées de l’exercice précédent, mais ces chaînes gaspillent de la mémoire et sont limitées en longueur. Pour trouver une solution cumulant les avantages des structures monolithiques et des structures ramifiées, il faudra utiliser le langage C++.
Exercice d’entrainement F.ent2.3
Dans cet exercice, nous allons implémenter une pile de chaines de caractères située complètement dans le tas et représentée par la structure suivante :
typedef struct
{
    int capa;
    int top;
    char** tab;
}pString;
Pour bien comprendre de quoi nous parlons, observons la représentation en mémoire d’une pile contenant les chaînes « Tim » et « Tom ».
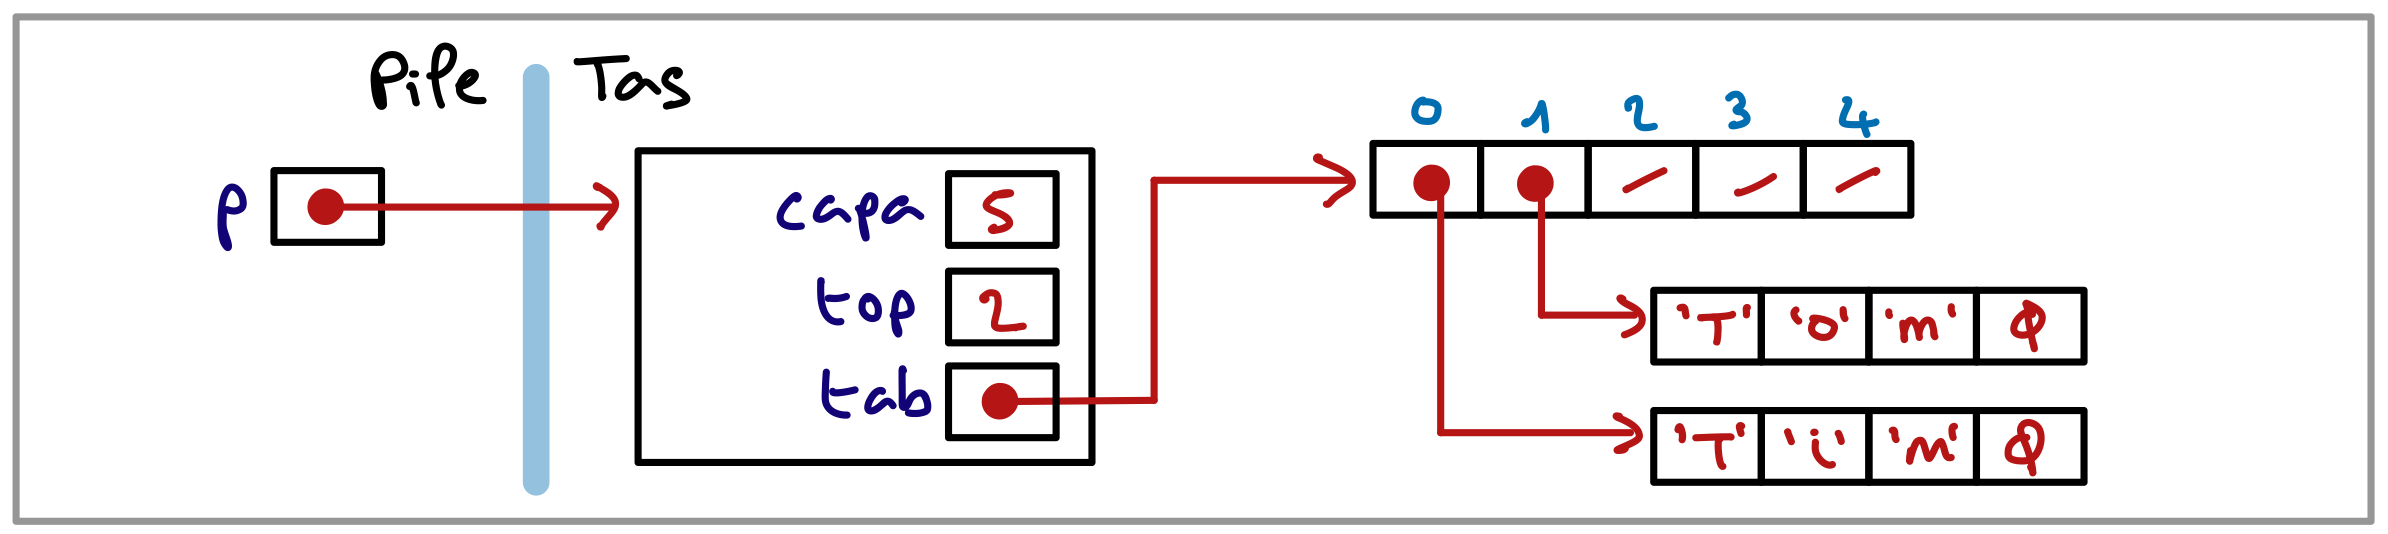
Les rôles des champs de la structure sont les suivants :
capa: Capacité du tableau de stockage, c’est à dire nombre maximum de chaînes pouvant être simultanément dans la pile. Cette valeur pourra augmenter en cas de besoin.top: Sommet de la pile, c’est à dire l’indice de la case du tableau de stockage où sera placée l’adresse de la prochaîne chaîne empilée.tab: Tableau de stockage des adresses des chaînes empilées. Chacune des cellules d’indice 0 àtop-1contient un pointeur désignant un bloc mémoire situé dans le tas contenant une chaîne de caractères.
Voici les fonctions à implémenter :
pString* creePstring(int capa): Crée une pile vide avec un tableau de stockage de capacitécapa. Le tableau de stockage est un tableau dechar*non initialisé.void delPstring(pString* p): Libère toute la méoire occupée par la pile désignées parp, y compris celle utilisée pour le stockage des chaînes encore empilées.void pushPstring(pString* p, const char* s): Empile dans la pile désignée parpune copie de la chaîne désignée pars.void popPstring(pString* p, char* dest): Retire de la pile désignée parpla dernière chaîne empilée (la plus récente) et la copie dans le tableau désigné pardest, qui est supposé avoir une taille suffisante.
Vous devez d’abord définir la fonction creePstring.
pString* creePstring(int capa)
{
    pString* out = (pString*)malloc(sizeof(pString));
    // À compléter
    return out;
}
Il reste à ajouter :
- L’initialisation du champ
capa. - L’initialisation du champ
top. - La création du tableau de stockage dont l’adresse doit être placéec dans le champ
tab.
pString* creePstring(int capa)
{
    pString* out = (pString*)malloc(sizeof(pString));
    out->capa = capa;
    out->top = 0;
    out->tab = (char**)malloc(capa*sizeof(char*));
    return out;
}
Donnez la définition de la fonction delPstring. Attention, le nombre de blocs mémoire à libérer dépend du nombre de chaînes encore empilées.
void delPstring(pString* p)
{
    for(int i=0; i<p->top; i++)
    {
        // À compléter
    }
    free(p->tab);
    free(p);
}
void delPstring(pString* p)
{
    for(int i=0; i<p->top; i++)
    {
        free(p->tab[i]);
    }
    free(p->tab);
    free(p);
}
Définissez la fonction pushPstring. Si la pile est remplie, sa capacité doit être augmentée. La fonction realloc est votre amie.
void pushPstring(pString* p, const char* s)
{
    if(p->top == p->capa)
    {
        p->capa = p->capa + 10;
        p->tab = (char**)realloc(p->tab, p->capa*sizeof(char*));
    }
    // À compléter
}
Il faut prêter attention au fait que le tableau de stockage est un tableau de pointeurs sur des caractères et donc que la taille de chaque cellule est sizeof(char*).
Il reste à :
- Créer dans le tas le tableaux de caractère qui contiendra la copie de la chaîne à empiler.
- Copier la chaîne à empiler dans ce tableau.
- Mettre à jour les valeurs des champs tab et top.
void pushPstring(pString* p, const char* s)
{
    if(p->top == p->capa)
    {
        p->capa = p->capa + 10;
        p->tab = (char**)realloc(p->tab, p->capa*sizeof(char*));
    }
    int n = strlen(s) + 1;
    p->tab[p->top] = (char*)malloc(n * sizeof(char));
    strcpy(p->tab[p->top], s);
    p->top++;
}
Vous devez définir la fonction popPstring. Dans le cas où la pile est vide, la fonction doit afficher un message d’erreur et provoquer un arrêt du programme par appel de exit(1). Attention de ne pas provoquer des fuites mémoire.
void popPstring(pString* p, char* dest)
{
    p->top = p->top - 1;
    if(p->top < 0)
    {
        printf("Erreur : pile vide\n");
        exit(1);
    }
    // À compléter
}
Il reste à recopier dans le tableau pointé par dest le contenu de la chaîne à dépiler, puis à libérer la mémoire occupée dans le tas par cette chaîne pour éviter une fuite mémoire.
void popPstring(pString* p, char* dest)
{
    p->top = p->top - 1;
    if(p->top < 0)
    {
        printf("Erreur : pile vide\n");
        exit(1);
    }
    strcpy(dest,p->tab[p->top]);
    free(p->tab[p->top]);
}
Vous devez donner les lignes de code permettant de :
- Créer une pile de chapines de capacité 10 désignée par une variable
pile. - Empiler les chaînes
"Tim"et"Tom". - Dépiler et afficher une chaîne.
- Dépiler à nouveau une chaîne et l’afficher.
- Libérer toute la mémoire occupée dans le tas.
    pString* pile = creePstring(10);
    pushPstring(pile, "Tim");
    pushPstring(pile, "Tom");
    char buf[100];
    popPstring(pile, buf);
    printf("%s\n", buf);
    popPstring(pile, buf);
    printf("%s\n", buf);
    delPstring(pile);
Pour récupérer les contenus des chaînes dépilées, il a été nécessaire de créer un tableau de destination qui a été appelé buf.
Activité de consolidation F.top
Réaliser cette activité consiste à traiter un des exercices de consolidation proposés. Si vous réalisez plusieurs fois cette activité, laissez passer au moins une semaine entre chaque itération et traitez à chaque fois un exercice différent.
Exercice de consolidation C.top1
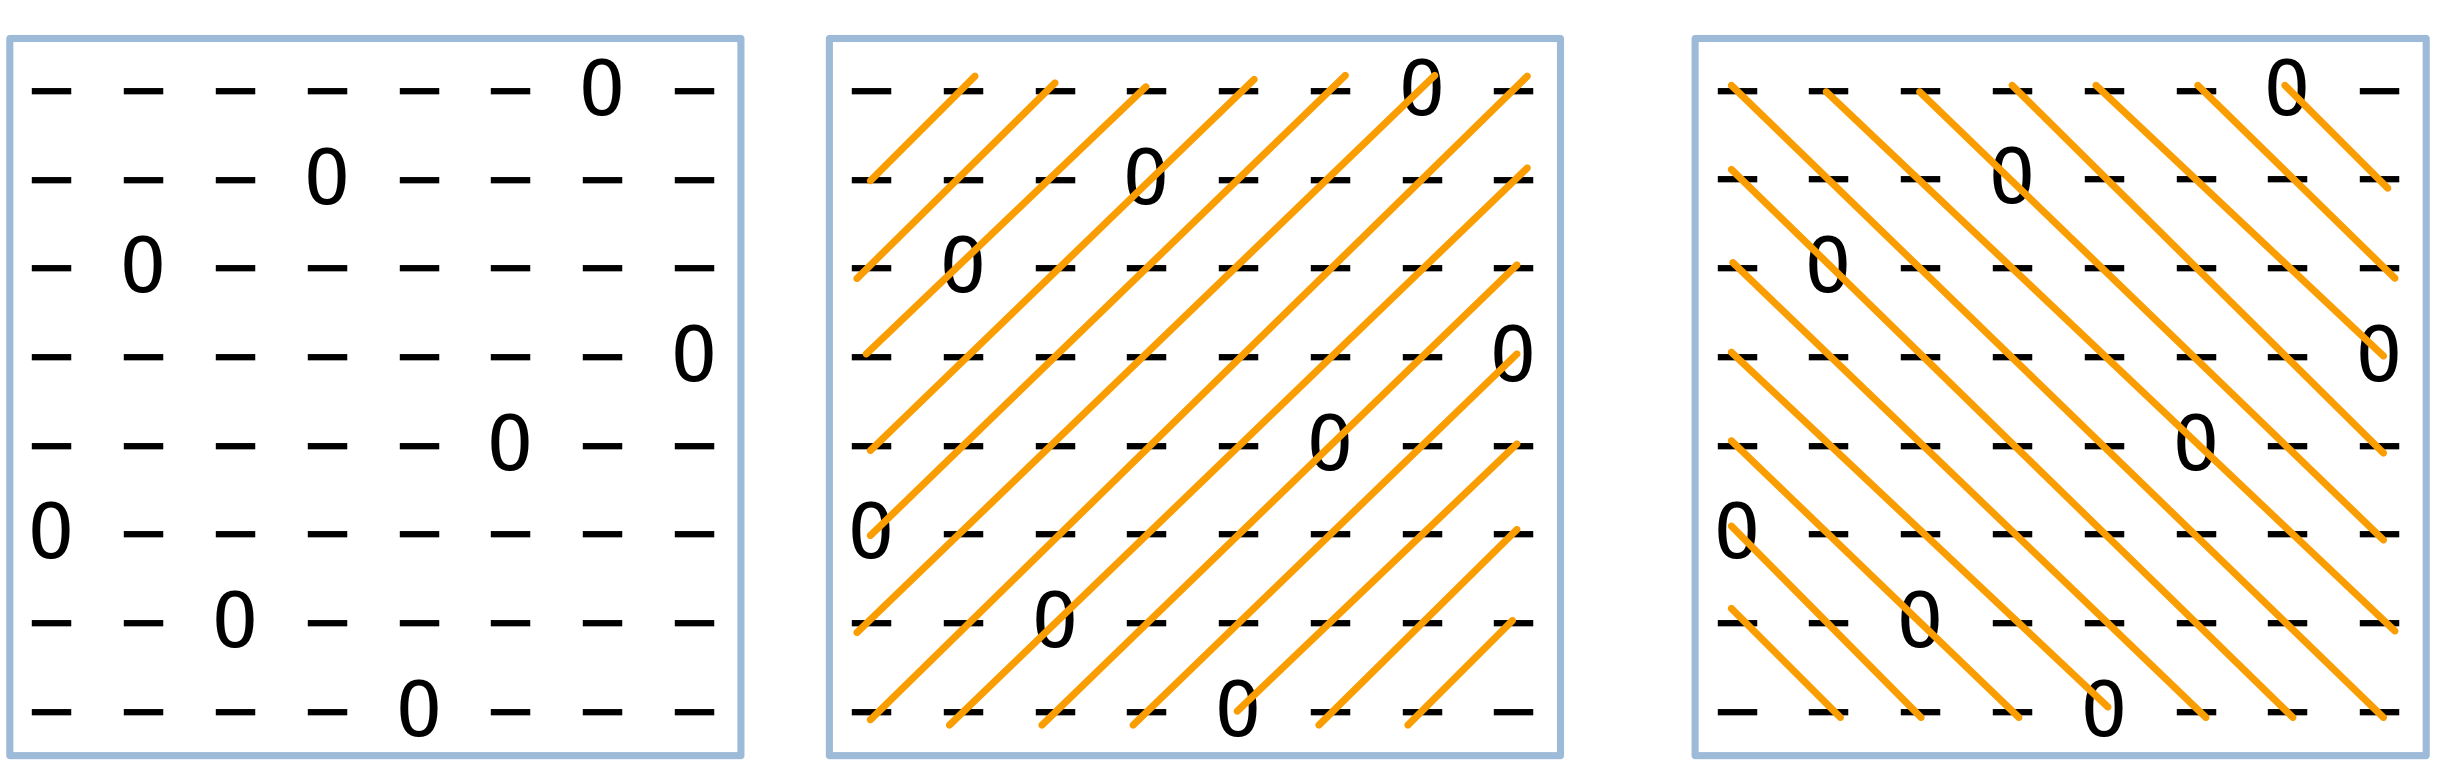
Le but de cet exercice est de résoudre un problème célèbre : réussir à placer (n) reines sur un échiquier de (n \times n) sans que plus d’une reine se trouve sur une même ligne, une même colonne ou une même diagonale.
Voici une solutions pour (n=8), parmi 92 possibles. Les diagonales ont été tracées pour permettre une vérification visuelle.
Il existe un algorithme produisant une solution particulière pour chaque valeur de (n), mais dans cet exercice nous utiliserons un procédé appelé recherche locale stochastique qui peut produire n’importe quelle solution par petites modifications aléatoires et sélections à partir d’une configuration initiale aléatoire.
Nous allons commencer par représenter une configuration des (n) reines sur un échiquier de (n) lignes et (n) colonnes. Pour limiter l’ensemble des configurations à explorer, appelé espace de recherche, nous considérerons uniquement les configurations dans lesquelles il y a exactement une reine sur chaque ligne et chaque colonne. Ces configurations peuvent être représentées par des permutations, en l’occurrence des listes d’entier tous différents compris entre 0 et (n-1).
Par exemple, la configuration suivante…
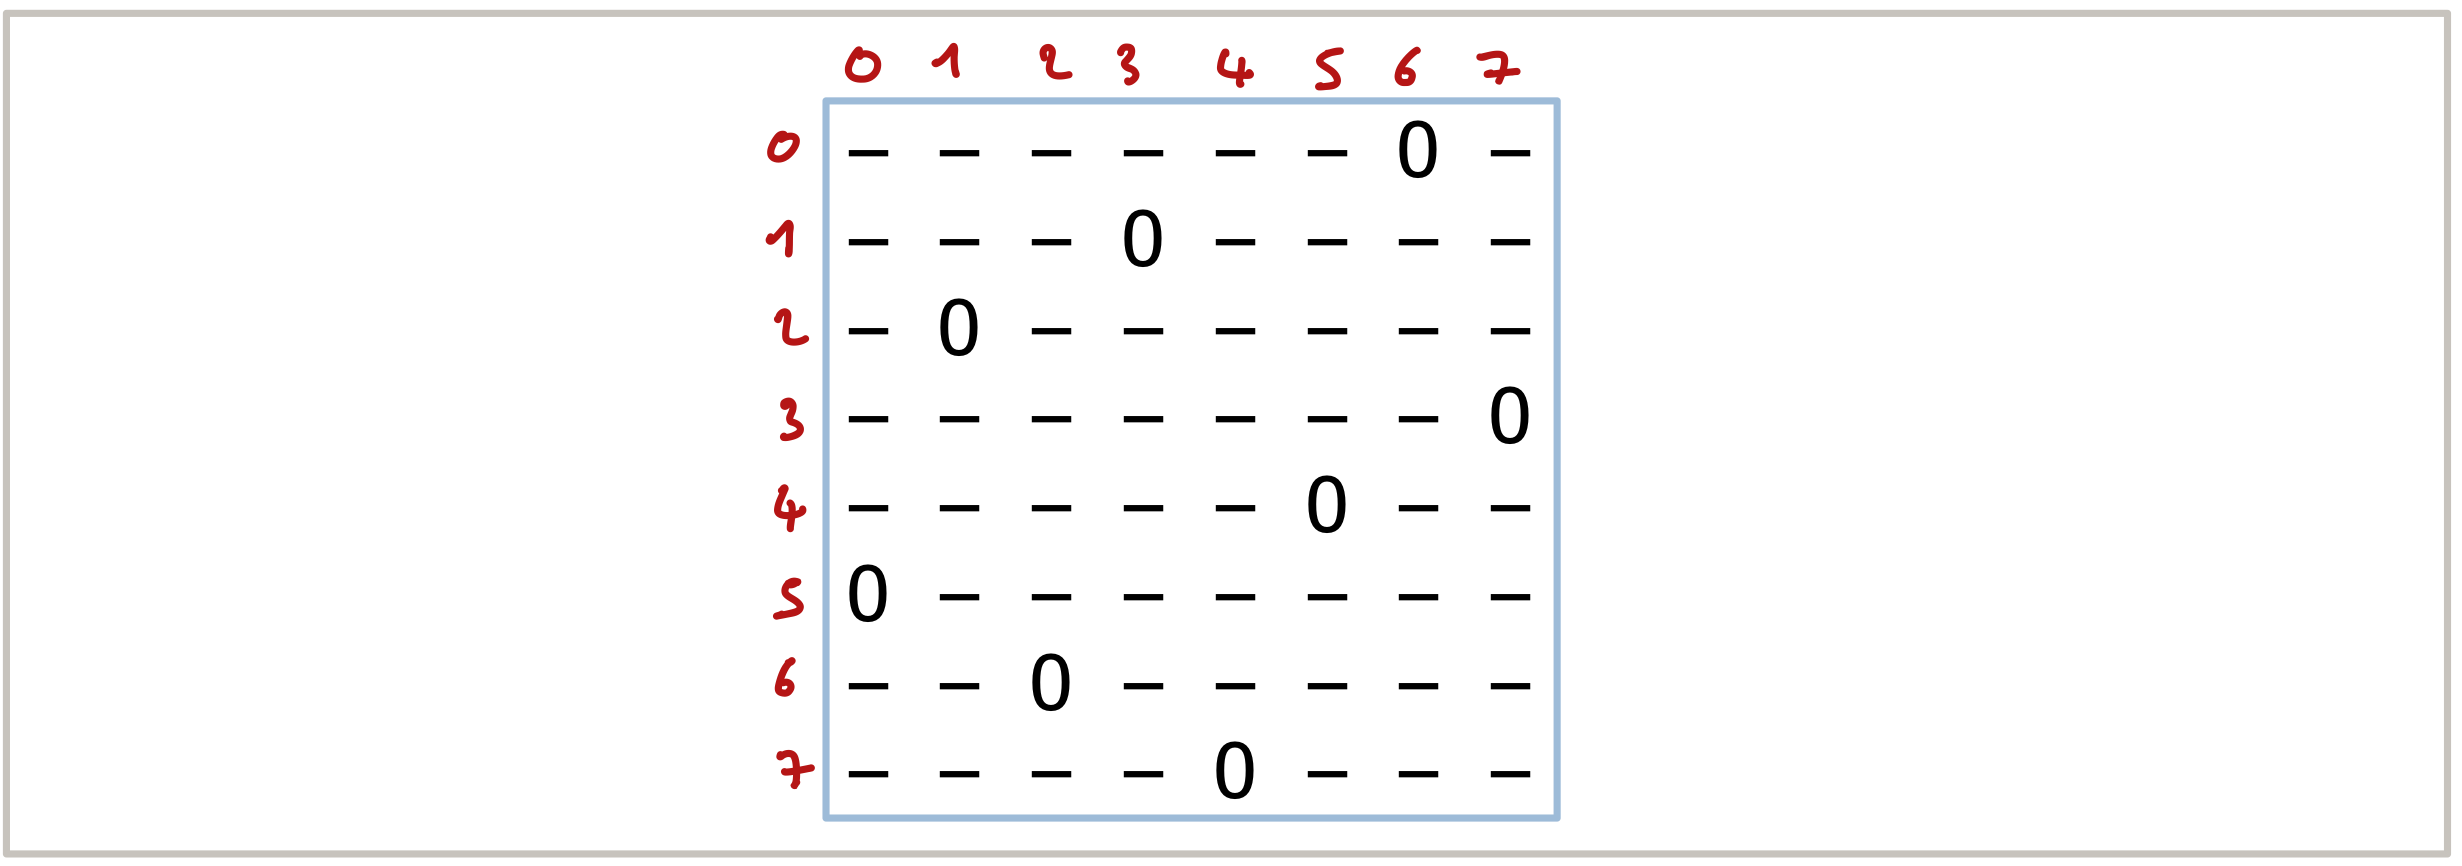
…se représente par la permutation ((6,3,1,7,5,0,2,4)). La première valeur représente la colonne sur laquelle se trouve la reine de la ligne 0, la deuxième représente la colonne de la reine située en ligne 1, etc.
Toutes les permutations ne représentent pas des solutions. Seulement un très petit nombre d’entre elles le sont. Mais toutes les solutions sont représentables par des permutations.
Une configuration sera représentée par la structure suivante…
typedef struct
{
    int n;
    int* tab;
}config;
…dans laquelle le champ n représente la taille de l’échiquier et le champ tab pointe un tableau dynamique contenant les valeurs de la permutation représentant les positions des reines.
Votre première mission consiste à implémenter les fonctions suivantes :
config* newConfig(int n): crée une instance deconfigsituée dans le tas, incluant le tableau destiné à recevoir les positions des reines. Le tableau n’est pas initialisé.void delConfig(config* c): libère la mémoire occupée par une configuration créée antérieurement par un appel ànewConfig.
config* newConfig(int n)
{
    config* out = (config*)malloc(sizeof(config));
    out->n = n;
    out->tab = (int*)malloc(n*sizeof(int));
    return out;
}

void delConfig(config* c)
{
    free(c->tab);
    free(c);
}
Vous devez maintenant définir les fonctions suivantes :
void randConfig(config* c): place dans l’instance deconfigpointée parcune configuration aléatoire. Attention, cette configuration doit comporter exactement une reine par ligne et par colonne, donc être représentée par une permutation. Tentez de trouver un algorithme efficace pour produire une permutation aléatoire.void printConfig(config* c): affiche à l’écran la configuration désignée par le paramètrec.
Commencez par définir printConfig.
void printConfig(config* c)
{
    for(int i=0; i<c->n; i++)
    {
        for(int j=0; j<c->n; j++)
        {
            if(j==c->tab[i])
                printf("O ");
            else
                printf("- ");
        }
        printf("\n");
    }
}
Le code dans la boucle for est découle du fait que la reine située sur la ligne i se trouve sur la colonne c->tab[i].
Ensuite définissez la fonction randConfig. Produire une efficacement une permutation aléatoire nécessite une réflexion algorithmique.
Vous pouvez utiliser le principe suivant :
- Produire la permutation \((0,1,2,\dots, n-1)\).
- Échanger la valeur située à chaque position avec une valeur située à une position tirée au hasard.
void randConfig(config* c)
{
    for(int i=0; i<c->n; i++)
    {
        c->tab[i] = i;
    }
    for(int i=0; i<c->n-1; i++)
    {
        int pos = rand()%c->n;
        int tmp = c->tab[i];
        c->tab[i] = c->tab[pos];
        c->tab[pos] = tmp;
    }
}
À présent, vous devez définir une fonction permettant de réaliser une petite modification aléatoire d’une configuration et une fonction permettant d’annuler cette modification. Une modification consiste à échanger deux valeurs de la permutation situées à des positions choisies au hasard. Pour pouvoir annuler une modification, on stocke les positions des valeurs échangées dans une instance de la structure suivante :
typedef struct
{
    int p1;
    int p2;
}modif;
Les deux fonctions à définir sont :
void changeConfig(config* c, modif* mod): Réalise un échange de deux valeurs tirées au hasard dans la permutation représentant la configuration désignée parcet place dans l’instance demodifdésignée parmodles positions échangées.void restoreConfig(config* c, const modif* mod) : Réalise dans la configuration désignée parcl’échange des deux valeurs situées aux positions mémorisées dans l’instance demodifdésignée parmod.
Commencez par définir changeConfig.
void changeConfig(config* c, modif* mod)
{
    mod->p1 = rand()%c->n;
    mod->p2 = rand()%c->n;
    int tmp = c->tab[mod->p1];
    c->tab[mod->p1] = c->tab[mod->p2];
    c->tab[mod->p2] = tmp;
}
Puis définissez la fonction restoreConfig.
void restoreConfig(config* c, const modif* mod)
{
    int tmp = c->tab[mod->p1];
    c->tab[mod->p1] = c->tab[mod->p2];
    c->tab[mod->p2] = tmp;
}
Pour faire fonctionner notre algorithme de recherche, nous avons besoin de calculer un score qui mesure la qualité d’une configuration. Ce score doit être égal à 0 pour les solutions et doit avoir une valeur élevée quand beaucoup de reines sont alignées avec d’autres sur des diagonales.
Le principe que nous utiliserons est le suivant : on comptabilise le nombre de reines « en trop » sur chacune des diagonales et on ajoute les valeurs obtenues. Par exemple, si une diagonale comporte 3 reines, il y a deux reines en trop, donc on ajoute 2 au score.
Pour calculer ce score efficacement, en parcourant une seule fois la permutation représentant la configuration à évaluer, nous allons utiliser un algorithme astucieux basé sur la numérotation des diagonales montantes et descendantes illustrée ci-dessous :
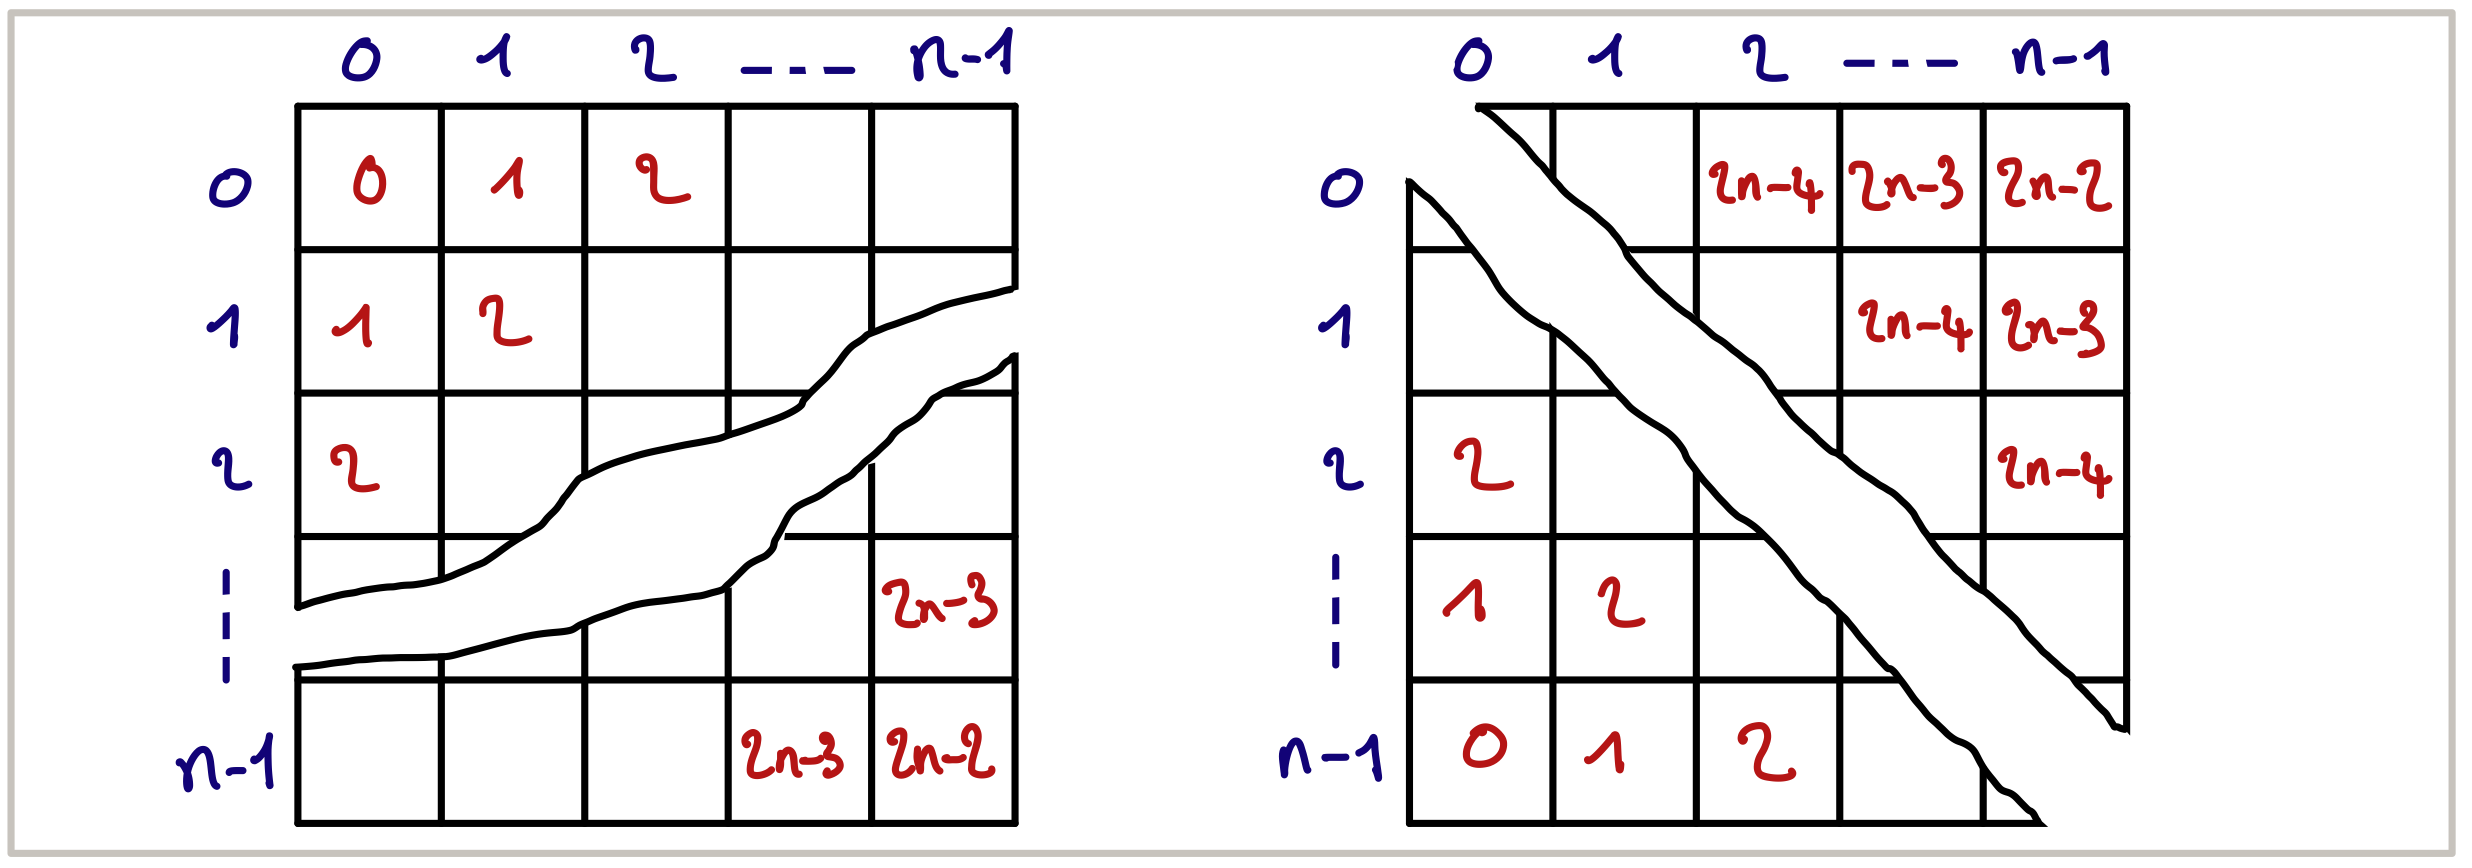
Les diagonales montantes sont numérotées de 0 à (2n-2) et les diagonales descendantes aussi. Une case située en ligne (i) et en colonne (j) appartient :
- à la diagonale montante numéroté \(i+j\),
- et à la diagonale descendantes numérotée \(n-1-i+j\).
Pour compter efficacement les reines placées sur chaque diagonale, nous utiliserons la structure suivante :
typedef struct
{
    int n;
    int* cptDM;
    int* cptDD;
}errCount;
Voici les rôles des champs de cette structure :
n: Nombres de cases dans les lignes et colonnes (utile pour calculer les numéros des diagonales).cptDM: pointe un tableau dynamique de2n-1cellules contenant chacune un entier.cptDD: pointe un tableau dynamique de2n-1cellules contenant chacune un entier.
Chaque cellule cptDM[i] servira à compter le nombre de reines sur la diagonale montante numéro i (pour i compris entre 0 et 2n-2). Les cellules du tableau pointé par cptDD auront le même usage pour les diagonales descendantes.
Le calcul du score se fait en mettant à 0 toutes les cellules des tableaux désignés par les champs cptDM et cptDD, puis en parcourant une seule fois toutes les positions occupées par une reine, à incrémenter cptDM[i] à chaque fois qu’une reine est sur la diagonale montante i et à incrémenter cptDD[i] à chaque fois qu’une reine est sur la diagonale descendante i.
Les informations recueillies dans ces tableaux permettent de déterminer le score de la configuration évaluée.
Il faut commencer par définir les fonctions permettant de créer dans le tas une instance de errCount et de la détruire ultérieurement.
errCount* newErrCount(int n): Crée une instance deerrCount(avec sa ramification) dans le tas.void delErrCount(errCount* e): Libère la mémoire occupée par une instance deerrCout.
errCount* newErrCount(int n)
{
    errCount* out = (errCount*)malloc(sizeof(errCount));
    out->n = n;
    out->cptDM = (int*)calloc((2*n)-1, sizeof(int));
    out->cptDD = (int*)calloc((2*n)-1, sizeof(int));
    return out;
}

void delErrCount(errCount* e)
{
    free(e->cptDM);
    free(e->cptDD);
    free(e);
}
Vous devez à présent définir la fonction void razErrCount(errCount* e) qui remet à 0 les cellules des deux tableaux de l’instance de errCount désignée par le paramètre e.
void razErrCount(errCount* e)
{
    for(int i=0; i<(2*e->n)-1; i++)
    {
        e->cptDM[i] = 0;
        e->cptDD[i] = 0;
    }
}
Vous devez définir la fonction int getScore(config* c, errCount* e) qui calcule le score de la configuration désignée par c en utilisant l’instance de errCount désignée par e pour le comptage des reines dans les diagonales. Cette instance de errCount est créée une seule fois et sert à chaque nouveau calcul de score pour des raisons d’efficacité. Ce choix de conception est justifié par le fait que la création et la destruction d’une instance de classe ramifiée a un certain coût en temps d’exécution.
int getScore(config* c, errCount* e)
{
    razErrCount(e);
    for(int i=0; i<c->n; i++)
    {
        int j = c->tab[i];
        e->cptDM[i+j]++;
        e->cptDD[c->n-1-i+j]++;
    }
    int score = 0;
    // À compléter
    return score;
}
La première partie donnée ici permet de compter les reines situées sur chaque diagonale montante et chaque diagonale descendante.
Il reste à exploiter les informations obtenues pour calculer le score.
int getScore(config* c, errCount* e)
{
    razErrCount(e);
    for(int i=0; i<c->n; i++)
    {
        int j = c->tab[i];
        e->cptDM[i+j]++;
        e->cptDD[c->n-1-i+j]++;
    }
    int score = 0;
    for(int i=0; i<(2*e->n)-1; i++)
    {
        if(e->cptDM[i]>1) score += (e->cptDM[i]-1);
        if(e->cptDD[i]>1) score += (e->cptDD[i]-1);
    }
    return score;
}
Il reste à définir la fonction config* searchSol(int n, int maxTries) qui recherche une solution du problème des n reines en faisant évoluer une configuration appelée configuration courante jusqu’à ce obtenir une solution ou dépasser maxTries étapes. Dans le cas où aucune solution n’est trouvée, la fonction doit retourner la valeur NULL.
- On produit une configuration aléatoire, qui est la première version de la configuration courante, et on calcule son score.
- À chaque nouvelle itération, on réalise une petite modification aléatoire de la configuration courante et on calcule sons score. Si le nouveau score est plus élevé que l’ancien, on annule la modification, sinon on conserve la modification.
config* searchSol(int n, int maxTries)
{
    config* conf = newConfig(n);
    randConfig(conf);
    modif mod;
    errCount* err = newErrCount(n);
    int score = getScore(conf,err);
    for(int i=0; i<maxTries; i++)
    {
        // À compléter
    }
    return NULL;
}
Nous avons ici les initialisations des données, la production de la première version de la configuration courante et le calcul de son score.
config* searchSol(int n, int maxTries)
{
    config* conf = newConfig(n);
    randConfig(conf);
    modif mod;
    errCount* err = newErrCount(n);
    int score = getScore(conf,err);
    for(int i=0; i<maxTries; i++)
    {
        changeConfig(conf, &mod);
        int newScore = getScore(conf,err);
        if(newScore>score)
        {
            // À compléter
        }
        else if(newScore==0)
        {
            // À compléter
        }
        else
        {
            score = newScore;
        }
    }
    return NULL;
}
config* searchSol(int n, int maxTries)
{
    config* conf = newConfig(n);
    randConfig(conf);
    modif mod;
    errCount* err = newErrCount(n);
    int score = getScore(conf,err);
    for(int i=0; i<maxTries; i++)
    {
        changeConfig(conf, &mod);
        int newScore = getScore(conf,err);
        if(newScore>score)
        {
            restoreConfig(conf,&mod);
        }
        else if(newScore==0)
        {
            delErrCount(err);
            return conf;
        }
        else
        {
            score = newScore;
        }
    }
    return NULL;
}
La fonction main suivante permet de tester la fonction de recherche d’une solution. À essayer avec différentes valeurs de (n) et du nombre maximum d’étapes de recherche.
int main()
{
    srand(time(NULL));
    config* sol = searchSol(8, 1000);
    if(sol==NULL)
    {
        printf("Aucune solution trouvée\n");
    }
    else
    {
        printConfig(sol);
        delConfig(sol);
    }
    return 0;
}
Voici un exemple de solution pour (n=30) trouvé « instantanément » par le programme :
- - - - - - - - - - - - O - - - - - - - - - - - - - - - - -
- - - - - - - - - - - - - - - - - - - - - - - - - - - O - -
- - - - - - O - - - - - - - - - - - - - - - - - - - - - - -
- - - - - - - - - - - - - - - - O - - - - - - - - - - - - -
- - - - - - - - - - - - - - - - - - - - O - - - - - - - - -
- - - - - - - - - - - - - - - - - - - - - - - - O - - - - -
- - - - - - - - - - - - - - - O - - - - - - - - - - - - - -
O - - - - - - - - - - - - - - - - - - - - - - - - - - - - -
- - - O - - - - - - - - - - - - - - - - - - - - - - - - - -
- - - - - - - - - O - - - - - - - - - - - - - - - - - - - -
- - - - - - - - - - - - - - - - - O - - - - - - - - - - - -
- - - - - - - - - - - - - - - - - - - - - - - - - O - - - -
- - - - - - - - O - - - - - - - - - - - - - - - - - - - - -
- - O - - - - - - - - - - - - - - - - - - - - - - - - - - -
- - - - - - - - - - - - - - - - - - - O - - - - - - - - - -
- - - - - - - - - - - - - - - - - - - - - - - - - - O - - -
- - - - - - - - - - O - - - - - - - - - - - - - - - - - - -
- - - - - - - - - - - - - - - - - - - - - - - O - - - - - -
- - - - - - - - - - - - - - - - - - - - - O - - - - - - - -
- - - - O - - - - - - - - - - - - - - - - - - - - - - - - -
- - - - - - - - - - - - - - - - - - - - - - - - - - - - O -
- - - - - - - - - - - O - - - - - - - - - - - - - - - - - -
- - - - - - - - - - - - - O - - - - - - - - - - - - - - - -
- - - - - - - O - - - - - - - - - - - - - - - - - - - - - -
- O - - - - - - - - - - - - - - - - - - - - - - - - - - - -
- - - - - - - - - - - - - - - - - - - - - - O - - - - - - -
- - - - - - - - - - - - - - - - - - O - - - - - - - - - - -
- - - - - - - - - - - - - - - - - - - - - - - - - - - - - O
- - - - - - - - - - - - - - O - - - - - - - - - - - - - - -
- - - - - O - - - - - - - - - - - - - - - - - - - - - - - -